Trong kỷ nguyên dữ liệu lớn và trí tuệ nhân tạo (AI), việc đảm bảo tính chính xác và tin cậy của thông tin đã trở thành ưu tiên hàng đầu của các tổ chức. Hai khái niệm thường bị nhầm lẫn nhưng đóng vai trò then chốt là chất lượng dữ liệu (data quality) và khả năng quan sát dữ liệu (Data Observability). Mặc dù cả hai đều hướng tới mục tiêu chung là dữ liệu sạch và sẵn sàng cho sử dụng, nhưng cách tiếp cận và phạm vi giải quyết vấn đề của chúng lại có sự khác biệt rõ rệt. Việc hiểu rõ Informatica Data Quality và Data Observability khác nhau như thế nào sẽ giúp các lãnh đạo dữ liệu như CIO, CDO và Head of Data xây dựng được một chiến lược quản trị dữ liệu (Data Governance) toàn diện, tránh tình trạng đầu tư chồng chéo hoặc bỏ sót các lỗ hổng vận hành nghiêm trọng.
Sự khác biệt căn bản nằm ở chỗ Informatica Data Quality tập trung vào trạng thái tĩnh của dữ liệu (dữ liệu có đúng định dạng, có bị trùng lặp hay không), trong khi Data Observability tập trung vào trạng thái động của toàn bộ hệ thống (dòng chảy dữ liệu có bị gián đoạn, pipeline có đang chạy chậm bất thường hay không). Trong một hệ sinh thái hiện đại như Informatica Intelligent Data Management Cloud (IDMC), hai thành phần này bổ trợ cho nhau để tạo ra một môi trường dữ liệu tự phục hồi và đáng tin cậy. Bài viết này sẽ phân tích chi tiết các điểm khác biệt, lợi ích và lộ trình triển khai để doanh nghiệp tối ưu hóa giá trị từ nguồn tài nguyên số của mình.
Table of Contents
Khái niệm cốt lõi: Informatica Data Quality và Data Observability là gì?
Để phân biệt rõ ràng, trước hết chúng ta cần định nghĩa chính xác từng thành phần trong kiến trúc dữ liệu hiện đại. Informatica Data Quality là một bộ giải pháp chuyên sâu giúp các doanh nghiệp xác định, làm sạch và quản lý độ tin cậy của dữ liệu trong suốt vòng đời của nó. Nó giải quyết các câu hỏi về tính chính xác, tính đầy đủ, tính nhất quán và tính hợp lệ của dữ liệu tại điểm đến hoặc trong kho lưu trữ.
Định nghĩa về Informatica Data Quality
Giải pháp Informatica Data Quality cung cấp các khả năng mạnh mẽ về data profiling (phân tích hồ sơ dữ liệu), data validation (xác thực dữ liệu) và Data Scrubbing (làm sạch dữ liệu). Công cụ này cho phép các Data Engineers và data quality Leads thiết lập các quy tắc kinh doanh (Business Rules) để kiểm tra xem dữ liệu có tuân thủ các tiêu chuẩn đã đề ra hay không. Ví dụ, hệ thống có thể tự động phát hiện các bản ghi khách hàng bị trùng lặp hoặc các trường số điện thoại thiếu mã quốc gia. Bằng cách sử dụng AI và Machine Learning thông qua engine CLAIRE, giải pháp này giúp tự động hóa việc gán nhãn dữ liệu và đề xuất các quy tắc làm sạch, từ đó giảm thiểu nỗ lực thủ công cho đội ngũ CNTT.
Định nghĩa về Data Observability
Ngược lại, Data Observability là khả năng hiểu được trạng thái của dữ liệu trong toàn bộ hệ thống bằng cách theo dõi các tín hiệu bên ngoài như Metadata, số lượng bản ghi, thời gian thực thi pipeline và các thay đổi về Schema. Thay vì chỉ kiểm tra nội dung bên trong một bảng dữ liệu, Data Observability quan sát hành vi của hệ thống để phát hiện các bất thường (Anomalies). Nếu Informatica Data Quality giống như một bài kiểm tra sức khỏe định kỳ cho các cơ quan bên trong cơ thể, thì Data Observability giống như một thiết bị giám sát nhịp tim và huyết áp hoạt động liên tục 24/7 để cảnh báo ngay lập tức khi có sự cố xảy ra. Khả năng quan sát tập trung vào việc duy trì SLA (thỏa thuận mức dịch vụ) cho các đường ống dẫn dữ liệu (Data Pipelines) và giảm thiểu thời gian chết của hệ thống.
So sánh Informatica Data Quality và Data Observability qua các tiêu chí kỹ thuật
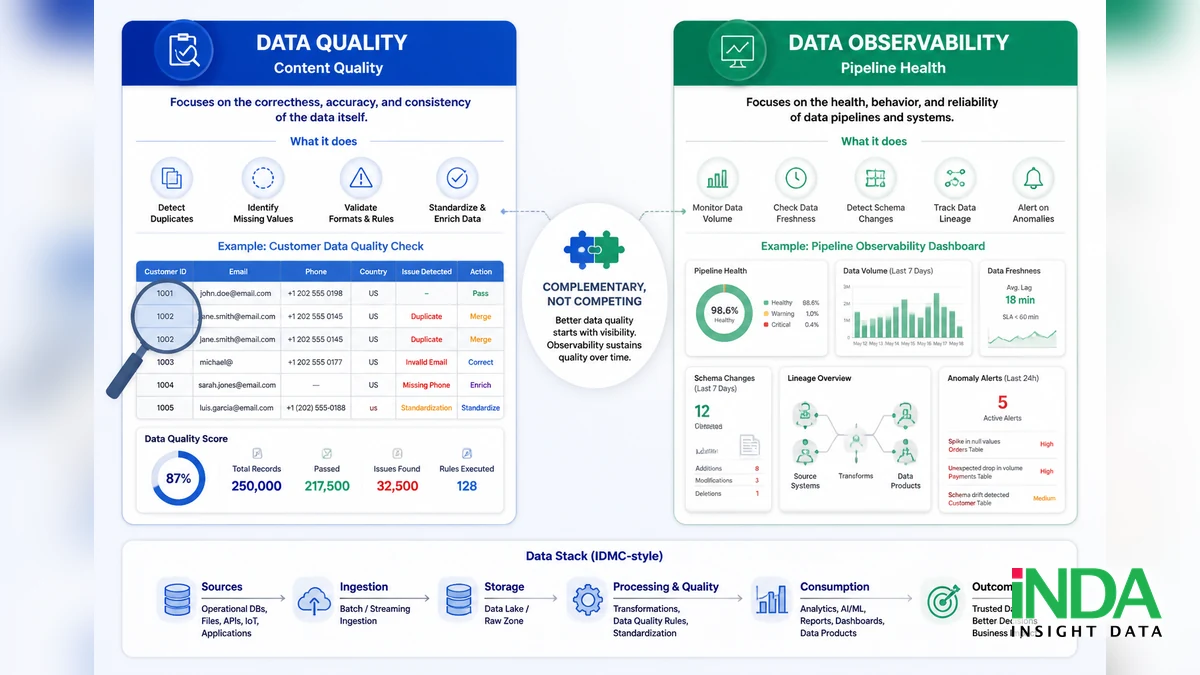
Việc đặt hai giải pháp này lên bàn cân giúp doanh nghiệp thấy rõ sự bổ trợ lẫn nhau thay vì thay thế nhau. Một hệ thống có data quality tốt nhưng thiếu Observability sẽ gặp khó khăn khi pipeline bị lỗi mà không biết nguyên nhân từ đâu. Ngược lại, một hệ thống có Observability tốt nhưng thiếu data quality sẽ chỉ báo cáo rằng pipeline vẫn chạy ổn, nhưng thực tế dữ liệu đổ về lại bị sai lệch về giá trị.
| Tiêu chí | Informatica Data Quality | Data Observability |
|---|---|---|
| Trọng tâm | Chất lượng nội dung dữ liệu (Data Content) | Sức khỏe của hệ thống và pipeline (Data Pipeline Health) |
| Thời điểm kiểm tra | Thường thực hiện trong quá trình ETL/ELT hoặc tại đích đến | Giám sát liên tục (Real-Time) trên toàn bộ dòng chảy dữ liệu |
| Phương pháp | Dựa trên quy tắc (Rule-based) và data profiling | Dựa trên Metadata, Lineage và phát hiện bất thường bằng AI |
| Người dùng chính | data quality Lead, Business Analyst, Data Steward | Data Engineer, Platform Engineer, Site Reliability Engineer |
| Mục tiêu chính | Đảm bảo dữ liệu đúng, sạch và nhất quán | Đảm bảo hệ thống vận hành liên tục và tin cậy |
| Phù hợp khi | Cần làm sạch dữ liệu cũ hoặc chuẩn hóa dữ liệu đầu vào | Cần giám sát các pipeline phức tạp trong môi trường Cloud-native |
Dựa trên bảng so sánh trên, có thể thấy Informatica Data Quality đóng vai trò như một “màng lọc” tinh vi, đảm bảo rằng chỉ những dữ liệu đạt chuẩn mới được đưa vào các hệ thống phân tích như Tableau, Power BI hay các mô hình AI. Trong khi đó, Data Observability đóng vai trò như một “hệ thống radar”, quét qua toàn bộ cơ sở hạ tầng để đảm bảo không có bất kỳ sự gián đoạn nào trong việc cung cấp dữ liệu. Sự kết hợp giữa hai yếu tố này tạo nên một chiến lược Data Ops mạnh mẽ, giúp doanh nghiệp giảm thiểu rủi ro và tăng cường niềm tin vào các quyết định dựa trên dữ liệu.
Phân tích sâu hơn, Informatica Data Quality sử dụng các kỹ thuật như so khớp (Matching), gộp (Merging) và chuẩn hóa (Standardization) để xử lý các vấn đề về dữ liệu thực tế. Trong khi đó, Data Observability sử dụng các chỉ số như Volume (khối lượng), Freshness (độ tươi mới), Schema (lược đồ dữ liệu) và Lineage (nguồn gốc dữ liệu) để đánh giá. Khi một báo cáo tài chính bị sai, data quality sẽ giúp bạn tìm ra dòng nào bị sai số, còn Data Observability sẽ chỉ ra rằng nguồn dữ liệu từ ERP đã không được cập nhật đúng giờ vào sáng nay.
Tại sao doanh nghiệp cần tích hợp cả hai giải pháp trong kỷ nguyên AI?
Trong bối cảnh các doanh nghiệp tại Việt Nam đang đẩy mạnh chuyển đổi số và ứng dụng AI, việc chỉ dựa vào một trong hai giải pháp là không đủ. Sự phức tạp của kiến trúc Data Lakehouse và môi trường Multi-cloud đòi hỏi một cách tiếp cận đa tầng để bảo vệ giá trị của dữ liệu. Việc tích hợp Informatica Data Quality cùng với các công cụ quan sát hiện đại mang lại lợi ích vượt trội cho cả đội ngũ kỹ thuật và kinh doanh.
Đảm bảo tính tin cậy cho các mô hình AI và Machine Learning
Các mô hình AI/ML cực kỳ nhạy cảm với chất lượng dữ liệu đầu vào. Nếu dữ liệu bị nhiễu hoặc không nhất quán, kết quả dự báo sẽ hoàn toàn sai lệch, dẫn đến rủi ro lớn về tài chính và uy tín. Informatica giúp doanh nghiệp chuẩn bị dữ liệu cho AI như thế nào là một chủ đề quan trọng, nhấn mạnh rằng chất lượng dữ liệu là nền móng. Tuy nhiên, nếu pipeline cung cấp dữ liệu cho mô hình bị trễ (vấn đề của Observability), mô hình sẽ hoạt động trên dữ liệu cũ, gây ra hiện tượng lệch mô hình (Model Drift). Do đó, sự kết hợp giữa việc làm sạch sâu của Informatica và việc giám sát dòng chảy của Observability là điều kiện tiên quyết để AI thành công.
Tối ưu hóa hiệu suất vận hành và giảm chi phí TCO
Việc phát hiện sớm các vấn đề thông qua Data Observability giúp giảm thời gian khắc phục sự cố (MTTR – Mean Time To Resolution). Khi một lỗi được phát hiện ngay tại nguồn hoặc trong quá trình chuyển đổi, đội ngũ kỹ sư có thể xử lý trước khi nó ảnh hưởng đến các báo cáo Dashboard của ban lãnh đạo. Đồng thời, việc sử dụng các quy tắc tự động trong Informatica Data Quality giúp giảm bớt các thao tác thủ công, tiết kiệm nguồn lực FTE (nhân sự quy đổi toàn thời gian) quý giá. Khi hệ thống vận hành trơn tru, chi phí tổng sở hữu (TCO) cho nền tảng dữ liệu sẽ được tối ưu hóa, mang lại ROI (tỷ suất hoàn vốn) cao hơn cho doanh nghiệp.
Tìm hiểu thêm về cấu trúc tổng thể của nền tảng tại Informatica IDMC gồm những gì và doanh nghiệp nên bắt đầu từ đâu để thấy rõ vị trí của các module này trong bức tranh lớn.
Lộ trình triển khai quản trị dữ liệu toàn diện với Informatica
Triển khai một hệ thống quản trị dữ liệu không phải là một công việc diễn ra một lần, mà là một hành trình liên tục. Đối với các doanh nghiệp đang bắt đầu với Informatica, lộ trình này nên được phân chia thành các giai đoạn rõ ràng để đảm bảo tính khả thi và đo lường được hiệu quả.
Giai đoạn 1: Đánh giá và profiling dữ liệu
Bước đầu tiên luôn là hiểu rõ trạng thái hiện tại của dữ liệu. Doanh nghiệp cần sử dụng khả năng data profiling của Informatica Data Quality để quét qua các nguồn dữ liệu chính như ERP, CRM hoặc Data Warehouse. Quá trình này giúp xác định các vấn đề phổ biến như giá trị Null, sai định dạng hoặc dữ liệu rác. Kết quả từ giai đoạn này sẽ là cơ sở để thiết lập các KPI về chất lượng dữ liệu và xác định các quy tắc kinh doanh cần ưu tiên áp dụng. Đây cũng là lúc để xác định các Metadata quan trọng cần được theo dõi.
Giai đoạn 2: Thiết lập quy tắc và cơ chế giám sát tự động
Sau khi đã có cái nhìn tổng quan, bước tiếp theo là xây dựng các quy tắc làm sạch và xác thực tự động. Các quy tắc này nên được nhúng trực tiếp vào các quy trình data integration để đảm bảo dữ liệu được kiểm tra ngay khi di chuyển qua các hệ thống. Đồng thời, triển khai các thành phần của Data Observability để theo dõi Lineage và sự biến động của dữ liệu. Việc tích hợp này đảm bảo rằng nếu một quy tắc data quality bị vi phạm, hệ thống Observability sẽ phát đi các Alerts ngay lập tức tới bộ phận liên quan thông qua các kênh như Email hoặc Slack. Để hiểu sâu hơn về cách quản lý các quyền truy cập và bảo mật trong quá trình này, quý độc giả có thể tham khảo Informatica Data Governance, Access và Privacy hoạt động ra sao.
Câu hỏi thường gặp về Informatica Data Quality
Informatica Data Quality có thể tự động sửa lỗi dữ liệu không?
Có, giải pháp này cung cấp các tính năng tự động làm sạch và chuẩn hóa dựa trên các quy tắc đã được thiết lập trước. Ví dụ, nó có thể tự động sửa lỗi chính tả tên thành phố hoặc định dạng lại ngày tháng theo tiêu chuẩn quốc tế. Tuy nhiên, đối với các trường hợp phức tạp, hệ thống sẽ gắn cờ (Flag) để các Data Steward xem xét và phê duyệt thủ công nhằm đảm bảo tính chính xác tuyệt đối.
Data Observability có thay thế được các bước kiểm tra data quality truyền thống không?
Không, Data Observability không thay thế mà bổ trợ cho data quality. Observability giúp bạn biết “khi nào” và “ở đâu” có sự cố xảy ra trong hệ thống, còn data quality giúp bạn biết “cái gì” sai trong nội dung dữ liệu và cách khắc phục nó. Một doanh nghiệp hiện đại cần cả hai để xây dựng một nền tảng dữ liệu thực sự vững chắc.
Chi phí triển khai Informatica Data Quality thường được tính như thế nào?
Chi phí thường phụ thuộc vào quy mô dữ liệu (về số lượng bản ghi hoặc dung lượng), số lượng nguồn dữ liệu kết nối và mô hình triển khai (On-premise hay cloud). Với phiên bản IDMC trên cloud, Informatica thường áp dụng mô hình tính phí dựa trên mức độ sử dụng (Consumption-based), giúp doanh nghiệp linh hoạt hơn trong việc quản lý ngân sách và mở rộng quy mô theo nhu cầu thực tế.
Doanh nghiệp nhỏ có cần thiết phải sử dụng cả hai giải pháp này không?
Đối với các SME (doanh nghiệp vừa và nhỏ) có cấu trúc dữ liệu đơn giản, có thể bắt đầu với các tính năng cơ bản của Informatica Data Quality để làm sạch các nguồn dữ liệu trọng yếu. Tuy nhiên, khi doanh nghiệp phát triển và số lượng pipeline tăng lên, việc bổ sung khả năng Observability là cần thiết để tránh tình trạng quá tải cho đội ngũ CNTT trong việc xử lý sự cố thủ công.
INDA đồng hành cùng doanh nghiệp xây dựng nền tảng dữ liệu tin cậy
Là đối tác tư vấn và triển khai các giải pháp dữ liệu hàng đầu tại Việt Nam, INDA hiểu rõ những thách thức mà doanh nghiệp gặp phải khi cố gắng cân bằng giữa chất lượng dữ liệu và hiệu suất vận hành. Chúng tôi không chỉ cung cấp các công cụ công nghệ mà còn mang đến kinh nghiệm thực chiến trong việc xây dựng khung quản trị dữ liệu (Data Governance Framework) phù hợp với đặc thù từng ngành nghề. Đội ngũ chuyên gia của chúng tôi sẽ hỗ trợ doanh nghiệp từ khâu đánh giá hiện trạng, thiết kế kiến trúc đến triển khai và chuyển giao công nghệ.
Việc lựa chọn và triển khai đúng giải pháp Informatica Data Quality kết hợp với tư duy quan sát dữ liệu hiện đại sẽ giúp tổ chức của bạn không chỉ có dữ liệu sạch mà còn có một hệ thống dữ liệu khỏe mạnh, sẵn sàng cho mọi mục tiêu kinh doanh và sáng kiến AI trong tương lai. INDA cam kết đồng hành cùng các CDO và CIO trong việc biến dữ liệu thành tài sản chiến lược thực sự, thúc đẩy sự đổi mới và tăng trưởng bền vững.
Hãy liên hệ với các chuyên gia tại INDA ngay hôm nay để nhận tư vấn chuyên sâu về lộ trình tối ưu hóa chất lượng dữ liệu cho doanh nghiệp của bạn.
Đọc thêm về dữ liệu và chuyển đổi số
- Vì sao Data Catalog là nền tảng cho self-service discovery
- Data Catalog là gì? Giải pháp quản trị và khai thác tài sản dữ liệu cho doanh nghiệp