Báo cáo theo thông tư 35/2015/TT-NHNN của ngân hàng nhà nước Việt Nam (NHNN) là một trong những yêu cầu tuân thủ phức tạp nhất đối với các tổ chức tín dụng. Để đáp ứng khối lượng dữ liệu khổng lồ và yêu cầu truy vết khắt khe, việc chuyển đổi sang một kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse hiện đại là xu hướng tất yếu. Thay vì dựa vào các kho dữ liệu truyền thống vốn chậm chạp và tốn kém, mô hình Lakehouse kết hợp sức mạnh của hồ dữ liệu (Data Lake) với tính quản trị của kho dữ liệu (Data Warehouse), cho phép ngân hàng xử lý dữ liệu từ Core Banking, Treasury và CRM một cách liền mạch, đảm bảo tính chính xác tuyệt đối cho mọi kỳ báo cáo định kỳ.
Table of Contents
Thách thức kỹ thuật khi triển khai báo cáo thông tư 35 theo mô hình cũ
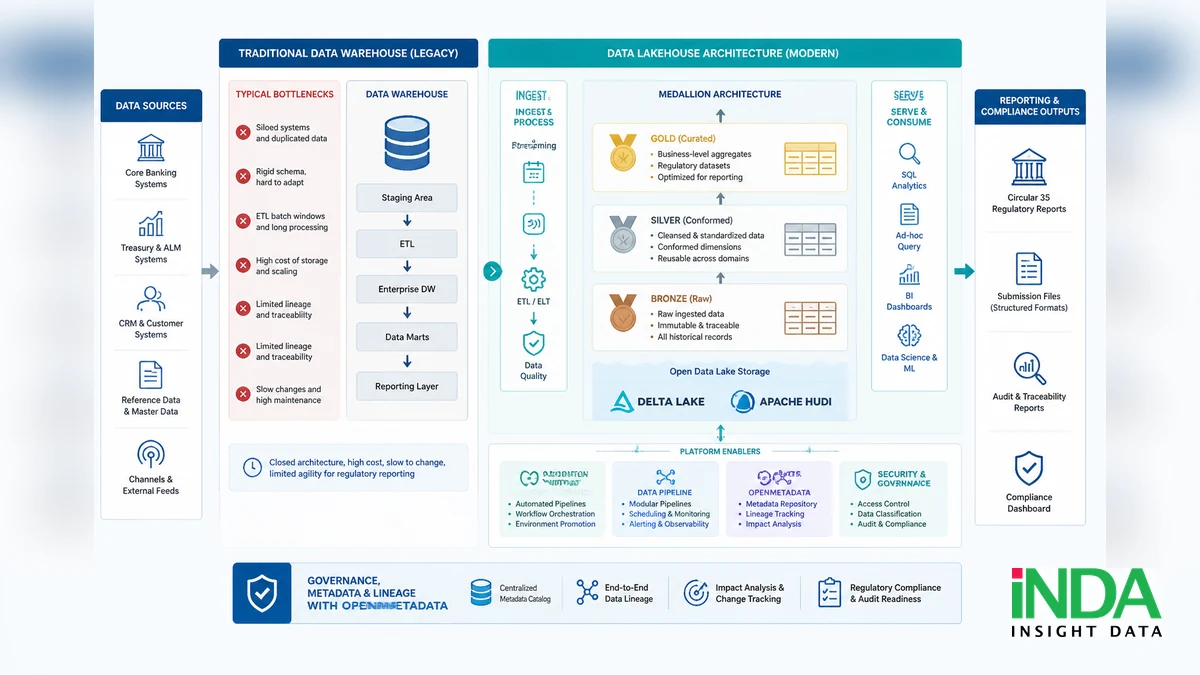
Các hệ thống báo cáo thống kê truyền thống tại nhiều ngân hàng Việt Nam hiện nay đang đối mặt với những rào cản lớn về hiệu suất và tính linh hoạt. Thông tư 35 đòi hỏi các tổ chức tín dụng phải nộp báo cáo định kỳ với hàng trăm biểu mẫu chi tiết, bao gồm cả dữ liệu tài chính lẫn phi tài chính. Khi số lượng giao dịch tăng vọt, kiến trúc Data Warehouse truyền thống dựa trên các hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) như Oracle hay SQL Server thường gặp hiện tượng nghẽn cổ chai trong quá trình ETL (Extract, Transform, Load).
Thứ nhất, việc hợp nhất dữ liệu từ nhiều nguồn khác nhau (siloed data) như Core Banking, hệ thống quản lý rủi ro và Treasury vào một kho dữ liệu duy nhất tiêu tốn rất nhiều tài nguyên tính toán. Thứ hai, các yêu cầu về hậu kiểm và truy vết (auditing) số liệu báo cáo rất khó thực hiện nếu hệ thống không lưu trữ được lịch sử thay đổi của từng bản ghi dữ liệu. Thứ ba, chi phí lưu trữ cho các bản sao dữ liệu khổng lồ phục vụ báo cáo trung hạn và dài hạn ngày càng tăng cao, gây áp lực lên ngân sách CNTT.
Ngoài ra, các thay đổi liên tục trong quy định của NHNN, ví dụ như các yêu cầu mới về an toàn thông tin hoặc chuẩn hóa dữ liệu thanh toán, đòi hỏi hệ thống phải có khả năng mở rộng nhanh chóng. Mô hình cũ thường yêu cầu tái cấu trúc bảng (schema change) rất phức tạp, dẫn đến rủi ro sai lệch số liệu hoặc chậm trễ thời hạn nộp báo cáo. Sự ra đời của kiến trúc Lakehouse đã giải quyết triệt để vấn đề này bằng cách tách biệt lớp lưu trữ và lớp tính toán, đồng thời hỗ trợ các tính năng quản trị dữ liệu cấp cao ngay trên nền tảng hồ dữ liệu.
Kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse và mô hình Medallion
Kiến trúc Data Lakehouse đại diện cho sự hội tụ của Data Lake và Data Warehouse. Trong bối cảnh ngân hàng, việc áp dụng mô hình Medallion (Bronze, Silver, Gold) của DataBricks là cách tiếp cận tiêu chuẩn để xây dựng kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse hiệu quả. Mô hình này giúp chuẩn hóa dữ liệu qua từng giai đoạn, đảm bảo rằng dữ liệu cuối cùng được sử dụng cho báo cáo NHNN là dữ liệu sạch và đã qua đối soát.
Lớp Bronze đóng vai trò là nơi lưu trữ dữ liệu thô (raw data) từ các nguồn như Core Banking hay hệ thống quản lý khoản vay. Dữ liệu tại đây được giữ nguyên định dạng ban đầu để phục vụ mục đích truy vết trong tương lai. Tại lớp Silver, dữ liệu được làm sạch, chuẩn hóa kiểu dữ liệu và thực hiện các phép join cơ bản. Đây là lớp cực kỳ quan trọng đối với báo cáo thông tư 35 vì nó giúp hợp nhất thông tin khách hàng từ CRM với thông tin giao dịch từ Core. Cuối cùng, lớp Gold chứa các bảng dữ liệu đã được tính toán sẵn theo các tiêu chí của NHNN, sẵn sàng để nộp lên cổng thông tin hoặc hiển thị trên Dashboard của Power BI hoặc Tableau.
Việc lựa chọn kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse còn mang lại lợi thế về chi phí nhờ sử dụng các dịch vụ đám mây như AWS hay Microsoft Fabric. Thay vì mua sắm máy chủ vật lý đắt đỏ, ngân hàng có thể sử dụng các cụm tính toán linh hoạt (clusters) chỉ khi cần xử lý báo cáo cuối kỳ. Điều này không chỉ giúp tối ưu hóa ROI mà còn đảm bảo hệ thống luôn sẵn sàng xử lý các yêu cầu báo cáo phát sinh đột xuất từ cơ quan quản lý. Để hiểu rõ hơn về bối cảnh pháp lý, bạn có thể tham khảo thêm về giải pháp báo cáo thông tư 35 NHNN: tổng quan và yêu cầu bắt buộc cho ngân hàng để có cái nhìn toàn diện nhất.
Vai trò của Delta Lake và Apache Hudi trong lưu trữ dữ liệu báo cáo
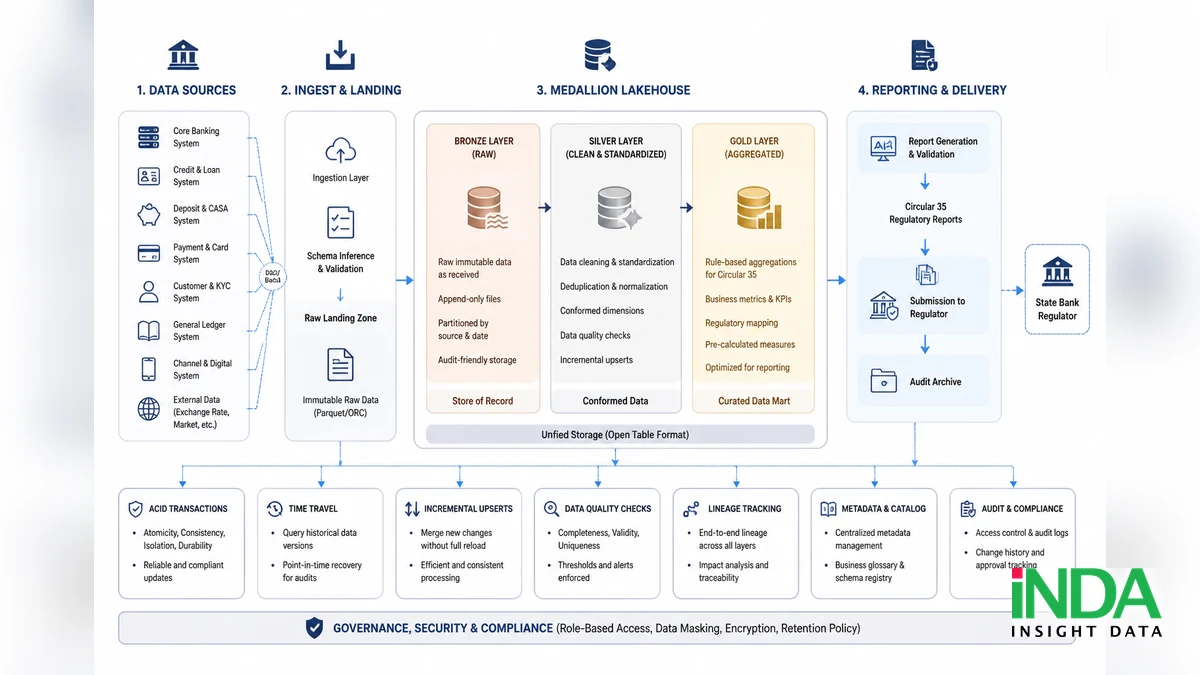
Để một kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse hoạt động ổn định, lớp lưu trữ (storage layer) đóng vai trò then chốt. Delta Lake và Apache Hudi là hai công nghệ hàng đầu hiện nay cung cấp khả năng thực hiện các giao dịch ACID (Atomicity, Consistency, Isolation, Durability) ngay trên Data Lake. Đối với báo cáo tuân thủ ngân hàng, tính năng này là bắt buộc để đảm bảo rằng dữ liệu không bị hỏng trong quá trình ETL và mỗi con số báo cáo đều có thể được giải trình.
Delta Lake, được phát triển bởi DataBricks, cung cấp tính năng “Time Travel” (du hành thời gian), cho phép các kỹ sư dữ liệu truy vấn dữ liệu tại một thời điểm chính xác trong quá khứ. Khi NHNN yêu cầu giải trình số liệu của một kỳ báo cáo cách đây 6 tháng, hệ thống có thể dễ dàng tái hiện lại trạng thái dữ liệu đúng lúc đó mà không cần phải phục hồi các bản Backup cồng kềnh. Ngoài ra, cơ chế Transaction Log của Delta Lake giúp ngăn chặn tình trạng xung đột khi nhiều pipeline dữ liệu cùng ghi vào một bảng đồng thời, một vấn đề thường gặp trong các ngân hàng lớn có lưu lượng giao dịch cao.
Trong khi đó, Apache Hudi lại nổi bật với khả năng xử lý các bản cập nhật gia tăng (incremental updates). Trong báo cáo thông tư 35, nhiều bảng dữ liệu như thông tin tài sản đảm bảo hoặc trạng thái nợ có thể thay đổi liên tục. Sử dụng Apache Hudi giúp hệ thống chỉ cần cập nhật những bản ghi có sự thay đổi (Upsert) thay vì phải ghi đè toàn bộ bảng dữ liệu hàng TB. Điều này làm giảm đáng kể thời gian chạy ETL cuối ngày và giúp các báo cáo nhanh chóng được hoàn thiện. Khi triển khai kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse, các kiến trúc sư thường phải cân nhắc giữa Delta Lake cho tính ổn định cao và Apache Hudi cho các pipeline yêu cầu tính gia tăng mạnh mẽ.
Trong kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse, việc tích hợp các công nghệ này vào một nền tảng Data Platform thống nhất giúp ngân hàng xây dựng một nguồn dữ liệu tin cậy duy nhất (Single Source of Truth). Dữ liệu sau khi được xử lý bởi Delta Lake hoặc Apache Hudi sẽ ở định dạng Parquet mở, cho phép nhiều công cụ BI và AI khác nhau có thể truy cập mà không bị ràng buộc bởi nhà cung cấp (Vendor Lock-in). Đây là yếu tố cốt lõi để duy trì tính bền vững của hệ thống công nghệ thông tin trong ngân hàng.
Tối ưu hóa pipeline báo cáo với quy trình ETL/ELT và CI/CD
Một thành phần không thể thiếu trong kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse chính là quy trình vận hành và triển khai tự động. Chuyển đổi từ mô hình ETL truyền thống sang ELT (Extract, Load, Transform) giúp tận dụng tối đa sức mạnh tính toán của các nền tảng như Spark trên DataBricks hay Snowflake. Trong mô hình này, dữ liệu thô được tải trực tiếp vào hồ dữ liệu trước khi các phép biến đổi logic báo cáo phức tạp được thực hiện, giúp giảm thiểu độ trễ dữ liệu.
Triển khai CI/CD (Continuous Integration/Continuous Deployment) cho các pipeline dữ liệu là bước đi mang tính đột phá cho các đội ngũ kỹ sư ETL. Mỗi khi có sự thay đổi về công thức tính toán trong thông tư 35, các đoạn code (Python/SQL) sẽ được kiểm thử tự động trên môi trường Staging trước khi đẩy lên môi trường production. Việc này giúp loại bỏ hoàn toàn các lỗi thủ công thường xảy ra khi các kỹ sư phải can thiệp trực tiếp vào Database. CI/CD đảm bảo rằng mọi thay đổi trong logic báo cáo đều được lưu vết trên Git, giúp kiểm soát phiên bản và dễ dàng quay lại trạng thái trước đó nếu có sự cố.
Bên cạnh đó, việc áp dụng CI/CD vào kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse còn giúp tăng tốc độ triển khai các POC (Proof of Concept). Ngân hàng có thể nhanh chóng thử nghiệm các mô hình báo cáo mới trên một lượng dữ liệu nhỏ để đánh giá hiệu quả trước khi triển khai trên toàn hệ thống. Để xem một ví dụ thực tế về cách vận hành này, bạn có thể đọc bài viết về Use case: triển khai POC báo cáo thông tư 35 trên nền tảng DataBricks và Power BI để nắm bắt quy trình từ thiết kế đến thực thi.
Quản trị Metadata và Lineage với OpenMetadata cho tính tuân thủ
Đối với báo cáo NHNN, việc biết được một con số trên báo cáo đến từ đâu và qua bao nhiêu bước biến đổi (Data Lineage) là yêu cầu quan trọng hàng đầu trong quản trị dữ liệu. Trong kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse, việc sử dụng các công cụ Metadata Catalog như OpenMetadata hoặc IBM Watson Knowledge Catalog giúp tự động hóa quá trình lập bản đồ dữ liệu. OpenMetadata cung cấp một cái nhìn tổng thể về vòng đời của dữ liệu, từ lúc rời khỏi Core Banking cho đến khi xuất hiện trên form báo cáo của thông tư 35.
Metadata không chỉ là mô tả về dữ liệu mà còn bao gồm các quy tắc kinh doanh (business rules), quyền truy cập và chất lượng dữ liệu (data quality). Khi triển khai kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse, hệ thống quản trị Metadata sẽ cảnh báo ngay lập tức nếu một trường dữ liệu quan trọng bị thiếu hoặc sai lệch định dạng. Điều này giúp bộ phận Data Office và các chuyên viên báo cáo có thể xử lý sự cố trước khi nộp báo cáo cho NHNN, tránh các rủi ro pháp lý và phạt vi phạm hành chính.
Việc duy trì một Metadata Catalog sạch sẽ cũng hỗ trợ đắc lực cho các cuộc thanh tra, kiểm tra của NHNN. Thay vì phải giải trình bằng các file Excel thủ công, ngân hàng có thể trình bày sơ đồ Lineage rõ ràng, chứng minh tính toàn vẹn của dữ liệu qua các lớp Bronze, Silver và Gold. Tính năng này giúp tăng cường sự tin tưởng của cơ quan quản lý đối với hệ thống CNTT của ngân hàng. Đây cũng là một phần quan trọng trong chiến lược giảm thiểu rủi ro và quản trị dữ liệu khi thực hiện báo cáo thông tư 35 mà các ngân hàng đang hướng tới.
Câu hỏi thường gặp về kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse
Tại sao nên chọn Data Lakehouse thay vì Data Warehouse truyền thống cho thông tư 35?
Kiến trúc Data Lakehouse vượt trội hơn vì khả năng xử lý đồng thời cả dữ liệu có cấu trúc và phi cấu trúc, với chi phí lưu trữ thấp hơn nhiều trên các nền tảng đám mây. Quan trọng hơn, nó hỗ trợ các tính năng hiện đại như Time Travel và ACID transactions trực tiếp trên Data Lake, điều mà Data Warehouse truyền thống rất khó thực hiện một cách linh hoạt và hiệu quả về chi phí khi quy mô dữ liệu lớn.
Delta Lake và Apache Hudi khác nhau như thế nào trong báo cáo ngân hàng?
Delta Lake thường được ưu tiên nhờ sự ổn định, tích hợp sâu với hệ sinh thái DataBricks và khả năng quản lý Metadata mạnh mẽ. Apache Hudi lại có thế mạnh trong việc xử lý các cập nhật gia tăng (incremental updates) và hỗ trợ tốt cho các truy vấn Snapshot. Tùy thuộc vào hạ tầng hiện có (ví dụ: AWS hay Azure), ngân hàng sẽ chọn công nghệ phù hợp nhất để xây dựng kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse của mình.
Làm thế nào để đảm bảo tính chính xác của dữ liệu giữa Core Banking và báo cáo cuối?
Bằng cách triển khai mô hình Medallion (Bronze/Silver/Gold) và các bước kiểm tra chất lượng dữ liệu (data quality checks) tự động tại mỗi lớp. Việc sử dụng Data Lineage từ các công cụ như OpenMetadata giúp truy vết nguồn gốc của mọi sai lệch, từ đó cho phép các kỹ sư dữ liệu điều chỉnh logic ETL/ELT kịp thời, đảm bảo số liệu báo cáo luôn khớp với số liệu thực tế tại hệ thống nguồn.
INDA tư vấn triển khai kiến trúc dữ liệu hiện đại cho báo cáo NHNN
Việc xây dựng một hệ thống báo cáo tuân thủ không chỉ đơn thuần là việc cài đặt công cụ, mà đòi hỏi một tư duy chiến lược về kiến trúc và quy trình quản trị. INDA với kinh nghiệm dày dặn trong lĩnh vực tư vấn dữ liệu tài chính – ngân hàng, cam kết đồng hành cùng các tổ chức tín dụng trong việc thiết kế và thực thi kiến trúc dữ liệu báo cáo thông tư 35 Data Lakehouse chuẩn quốc tế. Chúng tôi hiểu rõ những đặc thù của dữ liệu ngân hàng Việt Nam và các yêu cầu khắt khe từ phía ngân hàng nhà nước.
Đội ngũ chuyên gia của INDA sẽ hỗ trợ ngân hàng từ giai đoạn đánh giá hiện trạng, xây dựng POC đến triển khai thực tế trên các nền tảng hàng đầu như DataBricks, Microsoft Fabric hay AWS. Chúng tôi tập trung vào việc tối ưu hóa pipeline dữ liệu, triển khai CI/CD và thiết lập khung quản trị dữ liệu vững chắc để đảm bảo mọi kỳ báo cáo thông tư 35 đều diễn ra suôn sẻ, chính xác và minh bạch.
Hãy liên hệ với INDA ngay hôm nay để nhận tư vấn chuyên sâu về lộ trình hiện đại hóa kiến trúc dữ liệu báo cáo tuân thủ cho ngân hàng của bạn.
Đọc thêm về dữ liệu và chuyển đổi số
- Informatica data integration: 5 bước triển khai tối ưu cho môi trường đa cloud
- Giải pháp Informatica toàn diện cho quản trị dữ liệu doanh nghiệp