Trong kỷ nguyên số năm 2026, dữ liệu doanh nghiệp không còn đơn thuần là những con số nằm yên trên bảng tính để phục vụ các báo cáo doanh thu cuối tháng. Chúng ta đang chứng kiến một sự bùng nổ của “dữ liệu máy” (machine data) – từ hàng tỷ tín hiệu cảm biến IoT trong các nhà máy thông minh đến các luồng dữ liệu truyền phát (streaming) liên tục từ các ứng dụng di động toàn cầu.
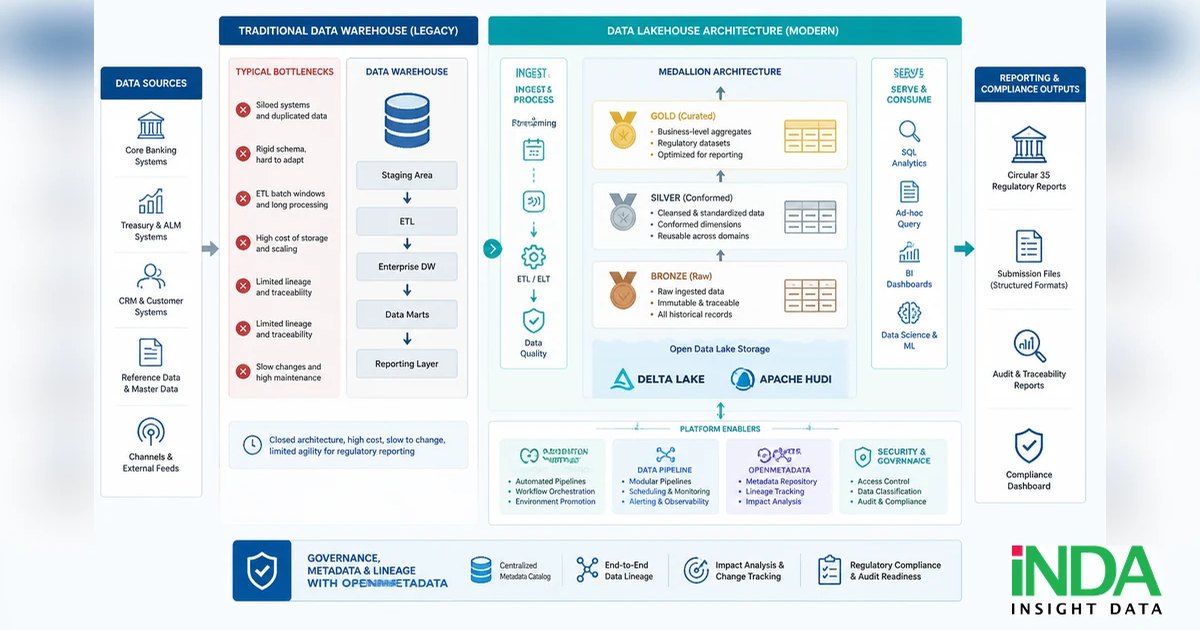
Các kiến trúc Data Warehouse truyền thống, vốn được thiết kế cho các tác vụ báo cáo tĩnh (reporting), đang dần trở nên hụt hơi trước những Data Lakehouse use cases trong doanh nghiệp đầy thách thức. AI cần dữ liệu huấn luyện liên tục và đa dạng, hệ thống Cybersecurity cần phát hiện tấn công trong vài mili giây, và các nền tảng quan sát (Observability) cần “tiêu hóa” hàng tỷ sự kiện mỗi ngày. Đây chính là lúc Data Lakehouse bước lên, không chỉ như một nơi lưu trữ, mà là “trái tim” của các hệ thống trí tuệ nhân tạo và phân tích thời gian thực.
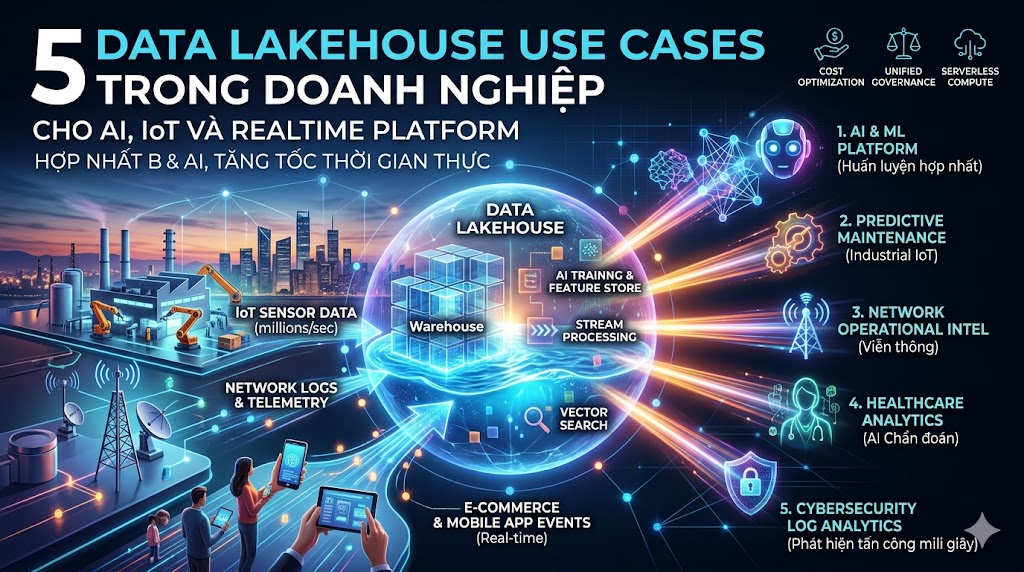
Table of Contents
Vì sao AI và Realtime Analytics cần Data Lakehouse?
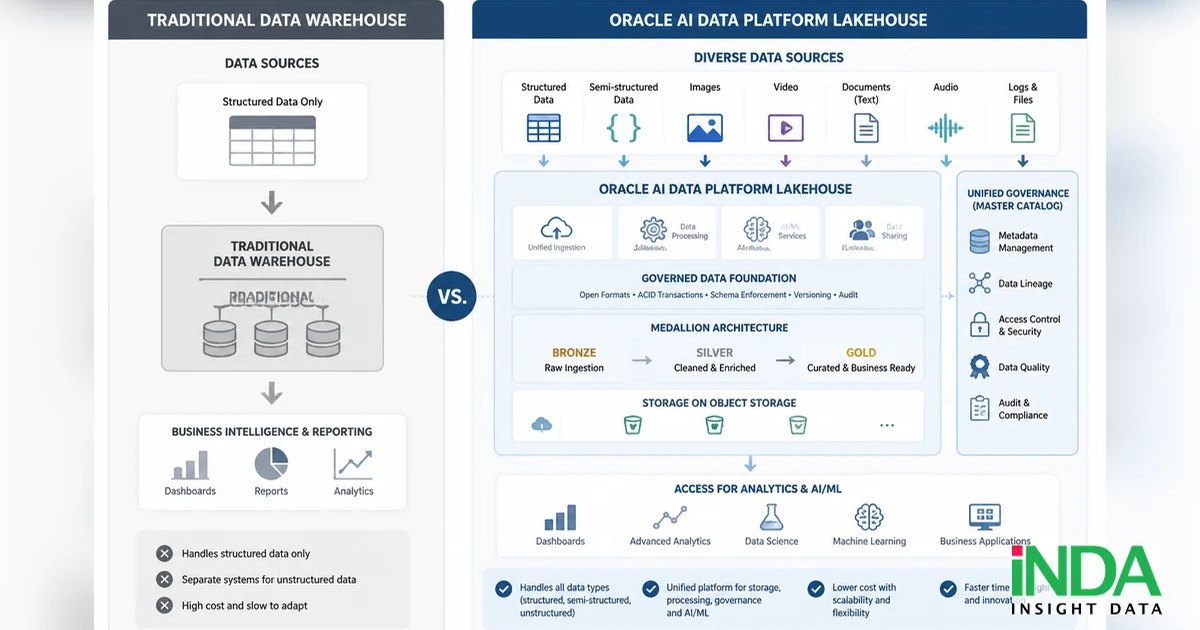
Để hiểu tại sao xu hướng này lại trở nên tất yếu, chúng ta cần nhìn vào bản chất của các workload hiện đại. AI không chỉ “ăn” dữ liệu có cấu trúc; nó cần video, hình ảnh, văn bản thô và các vector embeddings – những thứ mà kho dữ liệu truyền thống cực kỳ khó xử lý và tốn kém khi lưu trữ. Việc áp dụng các Data Lakehouse use cases trong doanh nghiệp giúp giải quyết bài toán đa dạng dữ liệu này trên một lớp lưu trữ duy nhất.
Bên cạnh đó, nhu cầu về Operational Intelligence (Trí tuệ vận hành) đòi hỏi doanh nghiệp phải phản ứng ngay lập tức. Nếu dữ liệu phải đợi chạy qua các đường ống ETL cồng kềnh mất vài tiếng đồng hồ mới vào đến kho, thì cơ hội để ngăn chặn một vụ gian lận tài chính hay dự báo một sự cố hỏng hóc máy móc đã trôi qua từ lâu.
Data Lakehouse giải quyết vấn đề này bằng cách hợp nhất:
- Dữ liệu đa dạng: Xử lý cả dữ liệu có cấu trúc và phi cấu trúc (unstructured data) trên cùng một storage layer.
- Tốc độ Streaming: Cho phép nạp và truy vấn dữ liệu theo thời gian thực nhờ các Open Table Formats như Delta Lake hay Apache Iceberg.
- Tính sẵn sàng cho AI: Cung cấp nền tảng lý tưởng cho việc xây dựng Feature Store và huấn luyện mô hình Machine Learning ngay tại nguồn dữ liệu.
Data Lakehouse đang thay đổi kiến trúc AI và Realtime Data ra sao?
Kiến trúc này tạo ra một sự thay đổi về chất trong cách tiếp cận dữ liệu của doanh nghiệp. Thay vì tách rời thế giới Analytics (phục vụ BI) và thế giới Data Science (phục vụ AI), Lakehouse tạo ra một AI-ready data platform duy nhất.
Bằng cách tận dụng Object Storage (như S3 hay Azure Blob) giá rẻ với quy mô Petabyte, doanh nghiệp có thể lưu trữ dữ liệu máy khổng lồ mà không lo về chi phí. Đặc biệt, việc tích hợp các bộ máy xử lý dòng (Streaming Engines) như Kafka hay Spark Structured Streaming giúp việc chuyển đổi dữ liệu thô thành thông tin có giá trị diễn ra gần như tức thì. Thay vì quy trình: Lưu trữ -> Chuyển đổi -> Phân tích, Lakehouse cho phép doanh nghiệp phân tích ngay khi dữ liệu đang chuyển động.
5 Use Cases phổ biến của Data Lakehouse cho AI và Operational Intelligence
Việc triển khai thành công các Data Lakehouse use cases trong doanh nghiệp đòi hỏi sự kết hợp giữa tư duy về kiến trúc hạ tầng và sự am hiểu sâu sắc về bài toán kinh doanh.
AI & Machine Learning Platform: Nền tảng huấn luyện hợp nhất
Đây là một trong những ứng dụng quan trọng nhất, giúp xóa bỏ rào cản kinh niên giữa đội ngũ Data Engineer và Data Scientist.
Bài toán doanh nghiệp: Trước đây, dữ liệu huấn luyện (training data) thường bị phân mảnh. Các kỹ sư phải sao chép dữ liệu từ Warehouse sang một môi trường khác để train model, gây ra tình trạng dữ liệu bị lỗi thời và lãng phí không gian lưu trữ. Việc quản lý các đặc trưng (feature engineering) cũng rất rời rạc, khiến pipeline ML không ổn định khi đưa vào thực tế.
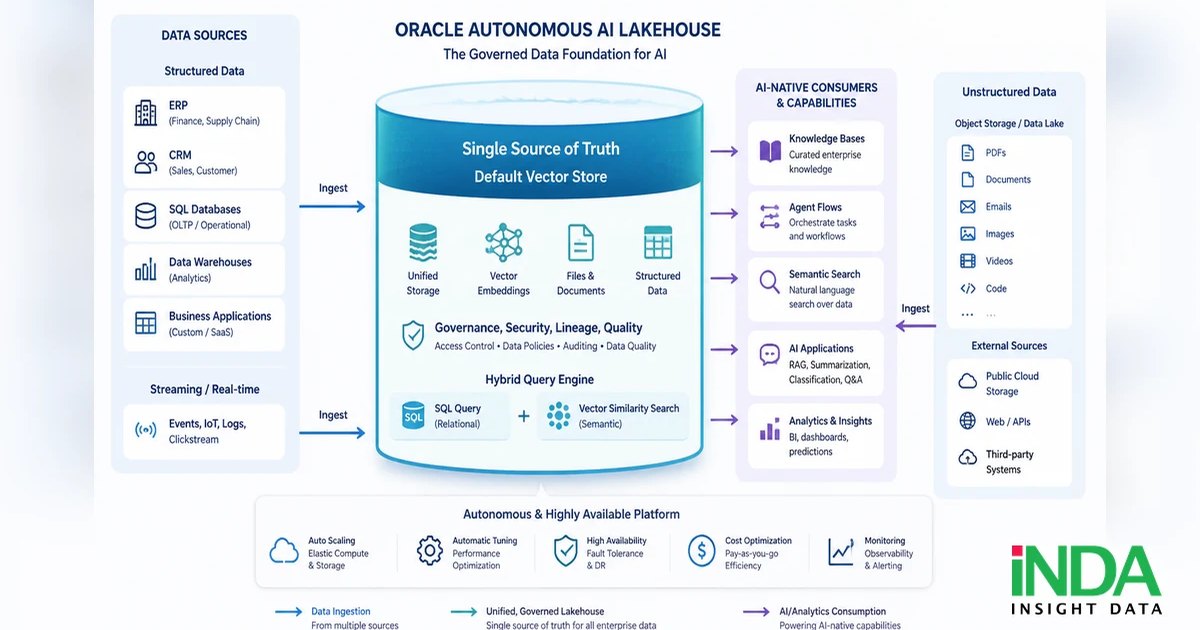
Giải pháp từ Lakehouse: Kiến trúc Lakehouse cung cấp một “Single Source of Truth” cho cả quá trình huấn luyện và dự đoán. Nó cho phép triển khai Feature Store tập trung – nơi các đặc trưng dữ liệu được định nghĩa một lần và sử dụng chung cho hàng ngàn mô hình.
Cơ chế vận hành: Dữ liệu thô đổ vào Lakehouse -> Xử lý tính năng (Feature Store) -> Huấn luyện mô hình với MLflow -> Triển khai Model Serving.
Lợi ích: Tăng tốc độ triển khai AI từ vài tháng xuống vài tuần, đảm bảo dữ liệu huấn luyện và dữ liệu thực tế luôn đồng nhất, giảm thiểu tối đa sai số mô hình.
Predictive Maintenance: Bảo trì dự báo trong Sản xuất (Industrial IoT)
Trong ngành công nghiệp 4.0, việc một dây chuyền sản xuất ngừng hoạt động đột ngột là “kẻ thù” số một của lợi nhuận doanh nghiệp.
Bài toán doanh nghiệp: Các nhà máy truyền thống thường bảo trì thiết bị theo lịch định kỳ (gây lãng phí linh kiện vẫn còn tốt) hoặc đợi hỏng mới sửa (gây tốn kém chi phí downtime khổng lồ). Dữ liệu cảm biến IoT quá lớn (tần suất gửi dữ liệu theo mili giây) khiến các hệ thống cũ không thể phân tích thời gian thực để đưa ra cảnh báo.
Lakehouse giải quyết như thế nào: Lakehouse đóng vai trò là một IoT analytics platform tiếp nhận hàng triệu tín hiệu từ cảm biến mỗi giây. Các mô hình dự báo sẽ chạy trực tiếp trên luồng dữ liệu này để phát hiện các mẫu rung động hoặc nhiệt độ bất thường (anomaly detection).
Cơ chế vận hành: Cảm biến IoT -> Kafka -> Spark Streaming -> Lakehouse -> Mô hình dự báo (Predictive Model).
Lợi ích: Giảm đến 30% chi phí bảo trì và hạn chế tối đa việc dừng máy ngoài ý muốn. Doanh nghiệp có thể biết trước một động cơ sẽ hỏng trong 48 giờ tới để chủ động thay thế vào giờ nghỉ.
Telecom Network Analytics: Giám sát vận hành mạng viễn thông
Ngành viễn thông cần xử lý lượng dữ liệu logs cực lớn từ hàng triệu thiết bị đầu cuối để đảm bảo chất lượng dịch vụ.
Bài toán doanh nghiệp: Lưu lượng log từ các trạm BTS và thiết bị mạng là khổng lồ. Việc tìm kiếm nguyên nhân gốc rễ (root cause analysis) khi có sự cố mạng thường mất nhiều giờ vì dữ liệu nằm rải rác trong các file log thô, khó truy vấn nhanh.
Lakehouse giải quyết như thế nào: Lakehouse trở thành một trung tâm operational intelligence cho các nhà mạng. Nó cho phép hợp nhất mọi loại telemetry data và logs vào một nơi duy nhất, hỗ trợ truy vấn nhanh nhờ cấu trúc dữ liệu được tối ưu hóa (như định dạng Parquet hoặc Z-ordering).
Cơ chế vận hành: Network Logs -> Kafka/Flink -> Lakehouse -> Dashboard giám sát thời gian thực.
Lợi ích: Cải thiện độ tin cậy của mạng lưới, giảm thời gian xử lý sự cố (MTTR) và cho phép nhà mạng dự báo lưu lượng để điều chỉnh tài nguyên băng thông một cách tự động.
Healthcare Analytics: Nền tảng dữ liệu bệnh nhân và chẩn đoán AI
Trong y tế, dữ liệu không chỉ là con số, nó là mạng sống và sự an toàn của bệnh nhân.
Bài toán doanh nghiệp: Dữ liệu bệnh nhân (EHR), hình ảnh chẩn đoán (DICOM) và dữ liệu từ các thiết bị theo dõi sức khỏe đeo tay thường nằm ở các hệ thống độc lập. Việc tổng hợp dữ liệu để phân tích tình trạng bệnh nhân theo thời gian thực hay nghiên cứu lâm sàng gặp rất nhiều khó khăn về mặt kỹ thuật và tuân thủ pháp lý.
Lakehouse giải quyết như thế nào: Lakehouse giúp xây dựng một predictive analytics platform cho y tế bằng cách hợp nhất mọi loại dữ liệu bệnh nhân trong khi vẫn đảm bảo các tiêu chuẩn an toàn thông tin khắt khe (như HIPAA hay GDPR). Nó hỗ trợ AI phân tích hình ảnh X-quang kết hợp với tiền sử bệnh án để đưa ra gợi ý chẩn đoán chính xác hơn.
Cơ chế vận hành: Hospital System + IoT Medical Device -> Lakehouse -> Nền tảng phân tích AI tích hợp.
Lợi ích: Cải thiện kết quả điều trị, cá nhân hóa phác đồ và tối ưu hóa vận hành bệnh viện thông qua việc dự báo lưu lượng bệnh nhân nhập viện.
Log Analytics & Cybersecurity: Giám sát an ninh mạng thời gian thực
Khi các cuộc tấn công mạng ngày càng tinh vi và tự động hóa, việc “biết chuyện gì đã xảy ra” vào ngày hôm sau là quá muộn.
Bài toán doanh nghiệp: Khối lượng log bảo mật từ tường lửa, máy chủ và ứng dụng là vô tận. Các hệ thống SIEM truyền thống thường gặp vấn đề về chi phí khi muốn lưu trữ log dài hạn (hàng năm) hoặc gặp độ trễ khi phải rà soát hàng tỷ bản ghi để tìm kiếm dấu vết tấn công.
Lakehouse giải quyết như thế nào: Lakehouse đóng vai trò là một cybersecurity analytics platform mở. Nó cho phép lưu trữ logs hàng năm với chi phí cực thấp trên Object Storage trong khi vẫn hỗ trợ các engine streaming để phát hiện mối đe dọa (threat detection) chỉ trong vài giây thông qua các thuật toán so khớp mẫu.
Cơ chế vận hành: Application Logs -> Kafka -> Streaming Analytics -> Lakehouse -> Security Dashboard & Alerting.
Lợi ích: Phát hiện tấn công nhanh hơn, đáp ứng tốt các yêu cầu về tuân thủ lưu trữ dữ liệu pháp lý và giảm sự phụ thuộc vào các công cụ SIEM đắt đỏ có cấu trúc đóng.
Kiến trúc Data Lakehouse điển hình cho AI và Realtime Analytics
Một hệ thống triển khai thành công các Data Lakehouse use cases trong doanh nghiệp thường tuân thủ kiến trúc 5 lớp mạch lạc để đảm bảo tính linh hoạt:
- Lớp nguồn dữ liệu (Ingestion Layer): Sử dụng các connector mạnh mẽ để thu thập dữ liệu từ IoT, telemetry, logs hệ thống và các stream giao dịch.
- Lớp nạp và truyền phát (Message Bus Layer): Sử dụng Apache Kafka hoặc Pulsar để làm “đệm” cho luồng dữ liệu, đảm bảo hệ thống không bị quá tải khi dữ liệu streaming đổ về ồ ạt.
- Lớp lưu trữ Lakehouse (Storage Layer): Đây là nơi sử dụng Object Storage (S3, ADLS) kết hợp với các định dạng bảng mở như Delta Lake. Lớp này đảm bảo các giao dịch ACID (tính nhất quán) và cho phép các kỹ sư “quay ngược thời gian” (time travel) để kiểm tra dữ liệu cũ.
- Lớp Compute & AI (Processing Layer): Nơi các engine như Apache Spark, Apache Flink hoặc Ray thực hiện các phép tính toán phức tạp, xử lý stream và huấn luyện mô hình Machine Learning ngay tại chỗ.
- Lớp Analytics & Monitoring (Consumption Layer): Cung cấp các dashboard thời gian thực, hệ thống cảnh báo tự động và API để các ứng dụng AI khác truy xuất dữ liệu.
Thách thức và Best Practices khi triển khai
Dù mang lại lợi ích to lớn, các Data Lakehouse use cases trong doanh nghiệp cũng đặt ra những thách thức không nhỏ.
- Độ phức tạp kỹ thuật: Kiến trúc streaming yêu cầu đội ngũ kỹ sư có kỹ năng cao hơn so với xử lý batch truyền thống. Việc xử lý “dữ liệu đến muộn” (late-arriving data) hay đồng bộ trạng thái (stateful processing) là những bài toán khó.
- Quản trị dữ liệu (Data Governance): Nếu không được quản lý tốt, Lakehouse có thể nhanh chóng trở thành một “đầm lầy dữ liệu”. Cần thiết lập các chính sách về Metadata, chất lượng dữ liệu (Data Quality) và kiểm soát truy cập ngay từ ngày đầu tiên.
- Chi phí Compute: Mặc dù lưu trữ rẻ, nhưng việc duy trì các cụm máy chủ chạy liên tục cho các tác vụ streaming có thể làm tăng hóa đơn Cloud. Doanh nghiệp cần sử dụng các tính năng Auto-scaling và Serverless để tối ưu hóa chi phí.
Best Practice: Hãy bắt đầu với một workload nhỏ nhưng có giá trị cao. Đừng cố gắng migrate toàn bộ hệ thống cùng lúc. Ưu tiên việc xây dựng một nền tảng quản trị (Governance) vững chắc trước khi mở rộng quy mô dữ liệu.
Kết luận
Thế giới dữ liệu đang dịch chuyển mạnh mẽ từ trạng thái “quan sát quá khứ” sang “phản ứng trong hiện tại” và “dự báo tương lai”. Kiến trúc Data Lakehouse không chỉ đơn thuần là một công nghệ lưu trữ mới, nó là một chiến lược giúp doanh nghiệp hợp nhất sức mạnh của AI và dữ liệu thời gian thực.
Bằng cách xây dựng một AI-ready data platform, doanh nghiệp không chỉ tối ưu hóa được vận hành thông qua Operational Intelligence mà còn tạo ra những giá trị mới từ chính lượng machine data khổng lồ đang bị bỏ phí. Trong cuộc đua số hóa khốc liệt, áp dụng thành công các Data Lakehouse use cases trong doanh nghiệp chính là chìa khóa để mở ra cánh cửa dẫn đến sự thông minh, linh hoạt và khả năng cạnh tranh tuyệt đối.
FAQ – Câu hỏi thường gặp
1. Data Lakehouse use cases trong doanh nghiệp phổ biến nhất là gì?
Phổ biến nhất hiện nay là xây dựng nền tảng ML/AI hợp nhất, bảo trì dự báo trong sản xuất (Predictive Maintenance), giám sát an ninh mạng thời gian thực và phân tích hành vi khách hàng đa kênh.
2. Lakehouse có thực sự hỗ trợ tốt cho Machine Learning không?
Rất tốt. Nhờ khả năng truy cập trực tiếp vào dữ liệu thô (unstructured) và dữ liệu có cấu trúc trên cùng một nền tảng, các Data Scientist có thể rút ngắn thời gian chuẩn bị dữ liệu và huấn luyện mô hình chính xác hơn.
3. Tại sao Kafka lại đóng vai trò quan trọng trong realtime analytics?
Kafka giống như “hệ thần kinh” trung tâm, đảm bảo dữ liệu streaming từ hàng ngàn nguồn được truyền tải ổn định, liên tục và không bị mất mát trước khi đi vào bộ máy xử lý của Lakehouse.
4. Khi nào doanh nghiệp cần AI-ready Lakehouse?
Khi các dự án AI của bạn bị đình trệ do dữ liệu phân mảnh, hoặc khi doanh nghiệp cần khả năng phát hiện bất thường (như gian lận, hỏng hóc) ngay tại thời điểm nó xảy ra thay vì nhận báo cáo vào ngày hôm sau.
5. Chi phí triển khai Lakehouse có đắt không?
Chi phí lưu trữ cực rẻ nhờ Object Storage. Chi phí chủ yếu nằm ở phần Compute (tính toán). Tuy nhiên, so với việc duy trì nhiều hệ thống rời rạc (Warehouse + Lake + AI Platform), tổng chi phí sở hữu (TCO) của Lakehouse thường tối ưu hơn nhiều.
Công ty TNHH Giải pháp Phân tích Dữ liệu Insight Data (INDA) là đơn vị hàng đầu cung cấp các dịch vụ và giải pháp về dữ liệu và trí tuệ nhân tạo (AI). Với chuyên môn sâu trong lĩnh vực Big Data, Data Analytics và AI Data Platform, chúng tôi cung cấp danh mục dịch vụ toàn diện bao gồm tư vấn và triển khai, thuê ngoài nhân sự IT, đào tạo và cung cấp bản quyền phần mềm.
Đội ngũ chuyên gia giàu kinh nghiệm của chúng tôi luôn cam kết đề cao chất lượng, tính chuyên nghiệp và sự thấu hiểu khách hàng – đồng hành cùng doanh nghiệp để mang đến những giải pháp phù hợp, hiệu quả, giúp khai mở tối đa tiềm năng từ dữ liệu.
Một số dịch vụ cơ bản INDA đang cung cấp:
Triển khai kho dữ liệu: Tư vấn, xây dựng, hỗ trợ về Data Warehouse và di chuyển Data Warehouse lên cloud.
Dịch vụ phát triển phần mềm: Tư vấn và hỗ trợ trang bị giấy phép phần mềm bản quyền (License).
Dịch vụ Outsourcing – Cho thuê nhân sự ngành Data: Tuyển dụng và sàng lọc ứng viên, có phương án dự phòng thay thế nhân sự kịp thời.
Dịch vụ Xây dựng Báo cáo BI: Cung cấp giải pháp chuyên sâu về Power BI.