Trong kỷ nguyên trí tuệ nhân tạo, việc xây dựng một hệ thống Data Lakehouse cho Machine Learning đang trở thành ưu tiên hàng đầu của mọi doanh nghiệp muốn dẫn đầu cuộc chơi AI. Tuy nhiên, một sự thật nghiệt ngã mà các kỹ sư học máy (ML Engineers) thường xuyên phải đối mặt là: Một mô hình AI hào nhoáng đến đâu cũng sẽ trở nên vô dụng nếu nó được xây dựng trên một nền tảng dữ liệu phân mảnh.
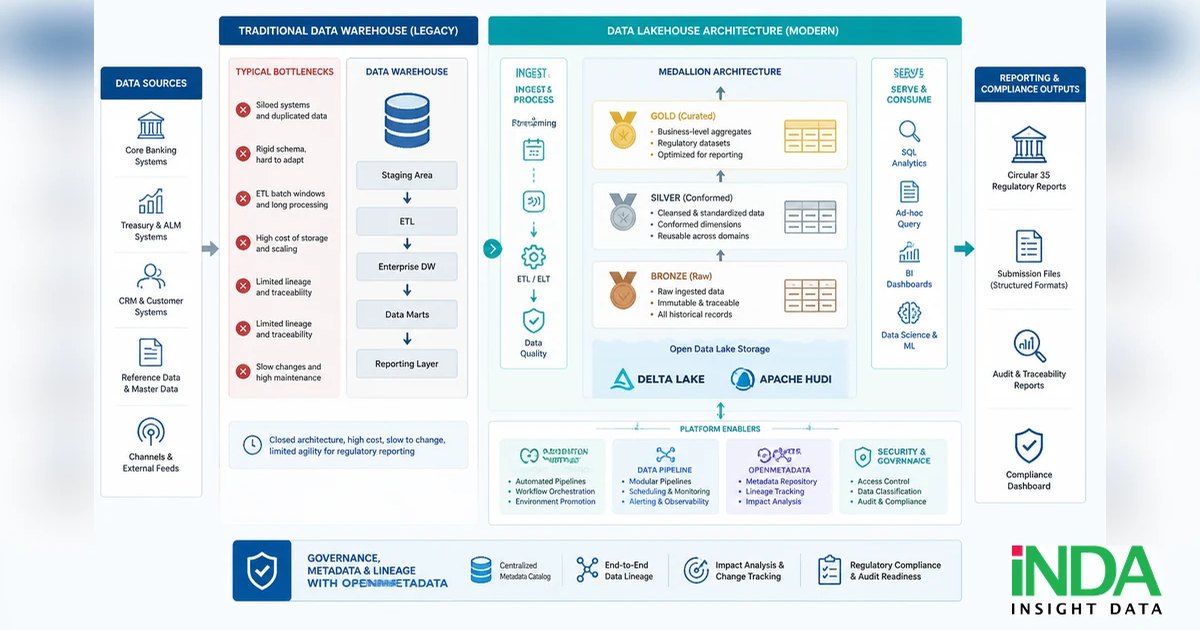
Hãy tưởng tượng kịch bản quen thuộc tại các tập đoàn lớn hiện nay: Dữ liệu phân tích lịch sử nằm “ngủ yên” trong Data Warehouse, dữ liệu thô (raw data) trôi nổi trong Data Lake, còn các Feature (đặc trưng) lại nằm ở một hệ thống riêng biệt. Sự đứt gãy này tạo ra một “cơn ác mộng” về vận hành: Pipeline phức tạp, dữ liệu bị sao chép vô tội vạ, chi phí lưu trữ tăng vọt và quan trọng nhất là tính quản trị (governance) gần như bằng không.
Đó là lý do vì sao kiến trúc Data Lakehouse cho Machine Learning xuất hiện như một lời giải duy nhất để hiện thực hóa giấc mơ Enterprise AI, giúp hợp nhất toàn bộ luồng dữ liệu từ phân tích đến huấn luyện mô hình trên một nền tảng duy nhất.
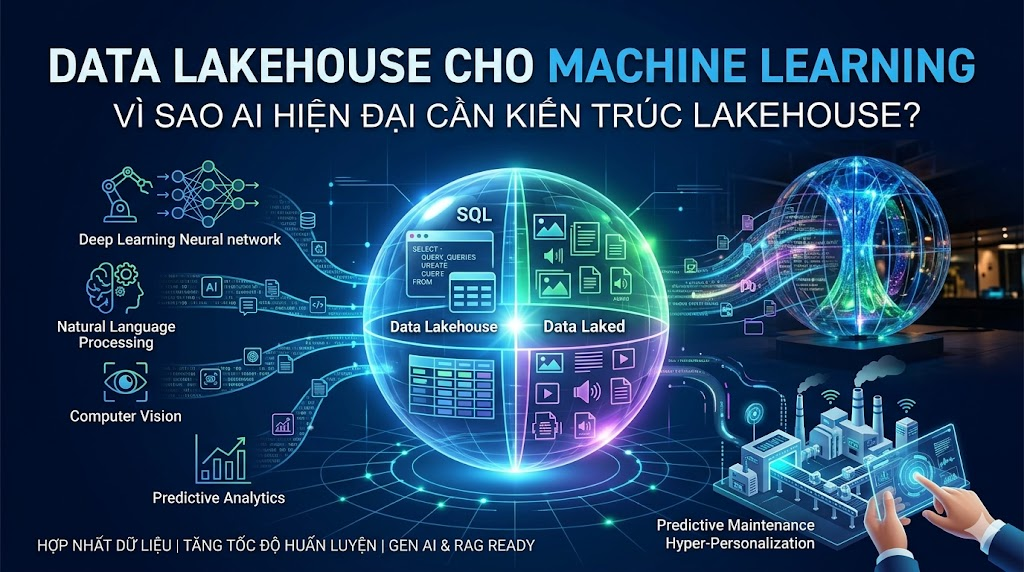
Table of Contents
Vì sao Machine Learning cần kiến trúc Lakehouse?
Để hiểu tại sao Lakehouse lại trở thành “ngôi sao mới”, chúng ta cần nhìn lại những giới hạn mang tính lịch sử của các mô hình truyền thống khi đối mặt với các khối lượng công việc (workload) đặc thù và khắt khe của AI.
1. Giới hạn của Data Warehouse trong Machine Learning
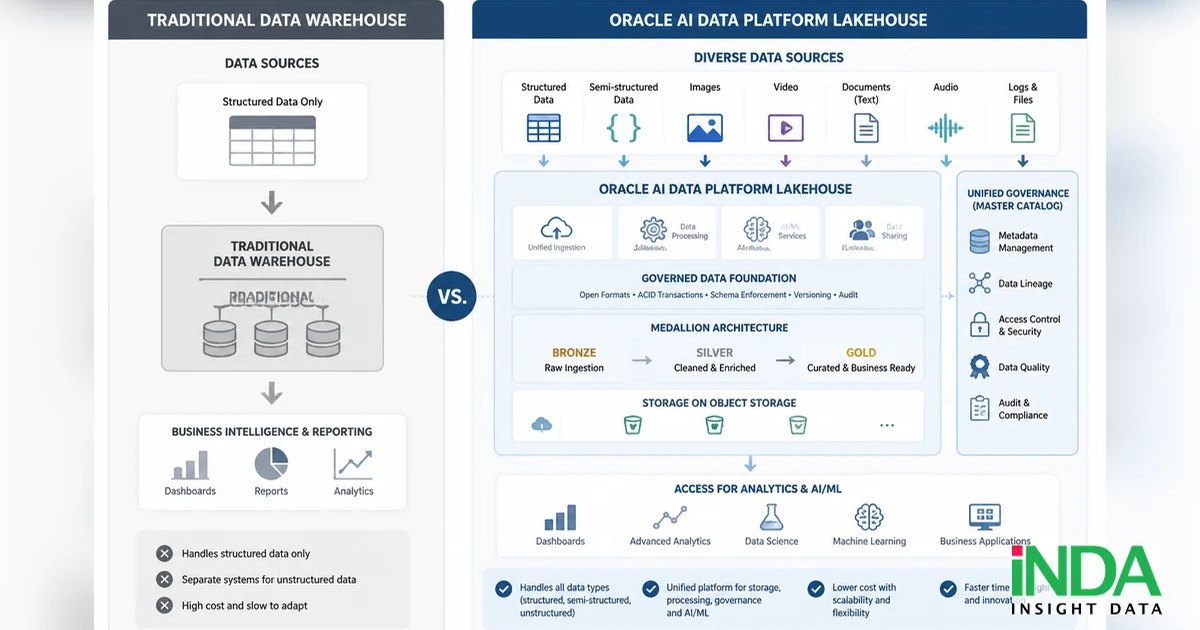
Data Warehouse vốn là “ông vua” của kỷ nguyên BI (Business Intelligence) với các truy vấn SQL chuẩn mực. Tuy nhiên, AI hiện đại không chỉ “ăn” các con số trong bảng tính. Các mô hình học sâu (Deep Learning) cần xử lý dữ liệu phi cấu trúc như hình ảnh, âm thanh và video. Data Warehouse truyền thống thường gặp khó khăn trong việc lưu trữ và xử lý hiệu quả các loại dữ liệu đa phương thức (multimodal data) này.
Việc cố gắng đưa dữ liệu phi cấu trúc vào Warehouse thường dẫn đến chi phí lưu trữ cực kỳ đắt đỏ và hiệu suất truy cập không tối ưu cho các thư viện ML như PyTorch hay TensorFlow. Triển khai Data Lakehouse cho Machine Learning giúp xóa bỏ rào cản này bằng cách cho phép các engine AI truy cập trực tiếp vào dữ liệu thô tại nguồn mà không cần thông qua các bước chuyển đổi (ETL) nặng nề làm mất đi các đặc tính nguyên bản của dữ liệu.
2. Giới hạn của Data Lake truyền thống
Data Lake ra đời để lưu trữ mọi thứ với chi phí rẻ. Nhưng cái giá phải trả là sự hỗn loạn. Một Data Lake thiếu lớp Metadata mạnh mẽ sẽ nhanh chóng biến thành “Data Swamp” (đầm lầy dữ liệu). Trong Machine Learning, tính tái lập (reproducibility) là yếu tố sống còn.
Nếu bạn không thể xác định chính xác phiên bản dữ liệu nào đã được dùng để huấn luyện mô hình nào vào thời điểm nào (do thiếu quản trị schema và time-travel), hệ thống AI của bạn sẽ trở thành một “hộp đen” không thể kiểm chứng. Các lỗi về lệch dữ liệu (data drift) sẽ rất khó bị phát hiện và xử lý trong một môi trường thiếu kiểm soát như vậy.
3. Lakehouse: Sự hội tụ tất yếu
Kiến trúc Data Lakehouse cho Machine Learning không chỉ là một công cụ, nó là sự kết hợp tinh hoa:
- Tính linh hoạt của Data Lake: Lưu trữ mọi định dạng dữ liệu (Parquet, Avro, JSON, PDF, Images).
- Tính quản trị của Data Warehouse: Hỗ trợ giao dịch ACID, quản lý Schema và bảo mật cấp độ hàng/cột.
- Hiệu suất cao cho AI: Tối ưu hóa cho các tác vụ đọc dữ liệu tuần tự lớn thường thấy trong quá trình huấn luyện mô hình (Model Training).
Phân tích sâu: Data Lakehouse cho Machine Learning hoạt động như thế nào?
Một hệ thống Data Lakehouse cho Machine Learning hoạt động như một “trạm trung chuyển tri thức” xuyên suốt vòng đời ML. Hãy đi sâu vào từng lớp kiến trúc để thấy sự khác biệt.
1. Unified Storage Layer và Open Table Formats
Đây là nền móng của toàn bộ hệ thống. Thay vì sử dụng các định dạng đóng, Lakehouse dựa trên các Open Table Formats như Apache Iceberg, Delta Lake hoặc Apache Hudi.
Các định dạng này cho phép:
- Time Travel: Giúp kỹ sư ML quay ngược thời gian để xem chính xác tập dữ liệu tại thời điểm mô hình được huấn luyện, phục vụ việc gỡ lỗi (debugging) và tuân thủ.
- Schema Evolution: AI là lĩnh vực thay đổi nhanh, dữ liệu đầu vào thường xuyên biến đổi. Lakehouse cho phép thay đổi cấu trúc bảng mà không làm hỏng các pipeline hiện có.
- Multi-engine support: Bạn có thể dùng Spark để xử lý dữ liệu lớn, dùng SQL để kiểm tra nhanh và dùng Python (thông qua Snowpark hoặc các thư viện tương tự) để huấn luyện mô hình cùng lúc trên một nguồn dữ liệu.
2. Feature Engineering và Feature Store tích hợp
Feature Engineering (Kỹ nghệ đặc trưng) chiếm tới 80% thời gian của một dự án ML. Trong kiến trúc Data Lakehouse cho Machine Learning, quá trình này được chuẩn hóa thông qua Feature Store.
- Offline Store: Lưu trữ các đặc trưng lịch sử trên Lakehouse để phục vụ huấn luyện mô hình quy mô lớn.
- Online Store: Đồng bộ các đặc trưng mới nhất xuống một key-value store (như Redis hoặc DynamoDB) để phục vụ dự đoán thời gian thực (real-time inference).
- Lineage tracking: Theo dõi luồng dữ liệu từ bảng gốc cho đến khi trở thành một Feature trong mô hình, giúp giải trình các quyết định của AI một cách minh bạch.
3. Distributed Training và Compute Architecture
Huấn luyện các mô hình như LLM hay mạng Neural sâu đòi hỏi sức mạnh tính toán kinh khủng. Lakehouse tận dụng khả năng tách biệt hoàn toàn giữa lưu trữ và tính toán. Khi bắt đầu quá trình huấn luyện, hệ thống sẽ khởi tạo các cụm tính toán phân tán (Distributed Clusters) có hỗ trợ GPU. Nhờ vào việc dữ liệu đã được tối ưu hóa (như Z-ordering hoặc Indexing trong Delta Lake), tốc độ nạp dữ liệu vào các worker (GPU) được đẩy lên tối đa, giúp giảm thời gian huấn luyện từ vài ngày xuống còn vài giờ.
Sự trỗi dậy của Generative AI và vai trò của Lakehouse
Năm 2026, không thể nói về Machine Learning mà không nhắc đến Generative AI. Kiến trúc Data Lakehouse cho Machine Learning đã tiến hóa để trở thành “xương sống” cho các ứng dụng GenAI doanh nghiệp.
Vì sao GenAI cần Lakehouse?
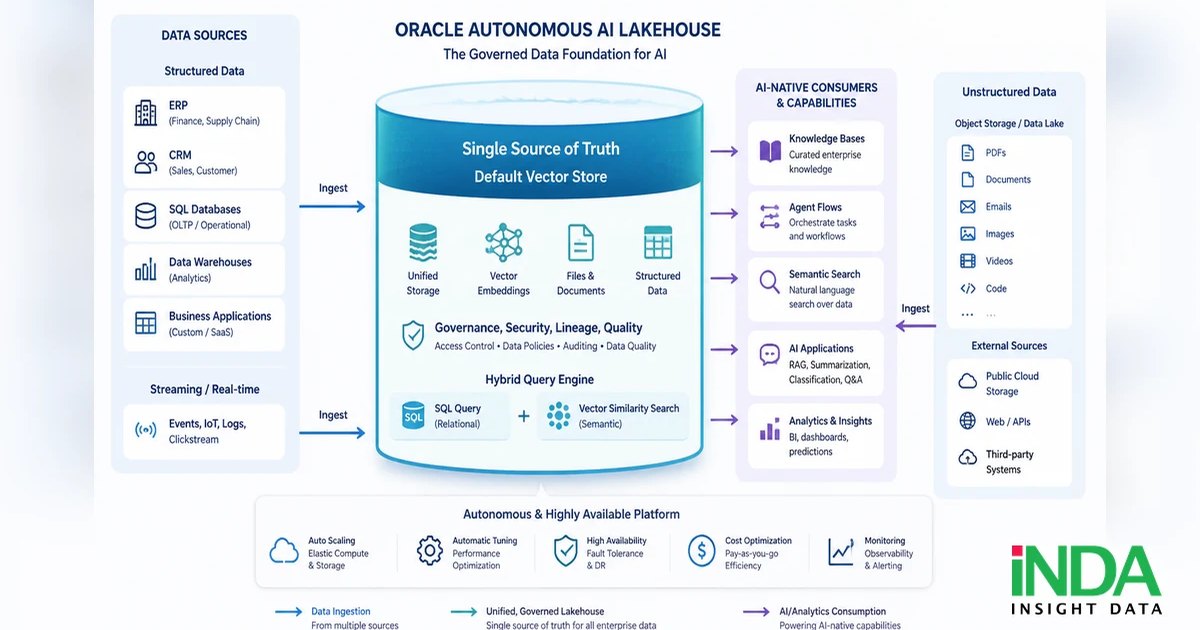
Các mô hình GenAI cần một lượng khổng lồ dữ liệu phi cấu trúc để tinh chỉnh (fine-tuning) hoặc thực hiện RAG (Retrieval-Augmented Generation). Nếu không có Lakehouse, việc quản lý hàng triệu tệp PDF, email hay ghi âm cuộc gọi sẽ là một thảm họa về mặt quản trị. Lakehouse cho phép doanh nghiệp:
- Lưu trữ Vector Embeddings: Nhiều hệ thống Lakehouse hiện đại (như Databricks với Vector Search hay Snowflake với Vector Data Type) cho phép lưu trữ và truy vấn các vector đặc trưng ngay trong cùng một nền tảng.
- Xây dựng RAG Pipeline tin cậy: Khi một LLM cần thông tin từ hợp đồng mới nhất để trả lời người dùng, Lakehouse đảm bảo rằng dữ liệu đó là mới nhất, đã được kiểm duyệt và có quyền truy cập phù hợp.
AI Governance và Trusted AI
Enterprise AI không chỉ là việc train model. Doanh nghiệp còn cần sự tin cậy. Metadata layer trong Data Lakehouse cho Machine Learning đóng vai trò là một “sổ cái” ghi lại mọi tương tác với dữ liệu AI. Bạn có thể biết chính xác:
- Mô hình nào đang sử dụng dữ liệu khách hàng nào?
- Dữ liệu đó đã được ẩn danh (anonymization) chưa?
- Có bất kỳ sự thiên lệch (bias) nào trong tập dữ liệu huấn luyện không?
So sánh: Data Lakehouse vs. Kiến trúc ML truyền thống
Để thấy rõ tại sao chúng ta nên chuyển đổi, hãy nhìn vào bảng so sánh chi tiết dưới đây:
| Tiêu chí | Kiến trúc ML truyền thống (Siloed) | Data Lakehouse cho Machine Learning |
| Dữ liệu nguồn | Phân mảnh giữa SQL Warehouse và NoSQL Lake | Hợp nhất trong một lớp lưu trữ mở duy nhất |
| Vòng đời dữ liệu | Phải sao chép (copy) qua nhiều hệ thống | Dữ liệu nằm tại chỗ, các engine đến và đọc |
| Quản trị (Governance) | Rời rạc, khó đồng bộ chính sách bảo mật | Quản trị tập trung (Unified Governance) |
| Hỗ trợ GenAI | Phức tạp (cần thêm Vector DB rời) | Tích hợp sẵn Vector Search và xử lý Unstructured |
| Tính nhất quán | Thấp (Dữ liệu train và test có thể lệch) | Cao (Nhờ Feature Store và Time Travel) |
| Chi phí vận hành | Cao do dư thừa hạ tầng và nhân sự quản lý | Tối ưu nhờ mô hình SaaS và Cloud-native |
Các Use Cases triển khai thực tế của Data Lakehouse cho Machine Learning
1. Hệ thống cá nhân hóa hành vi (Hyper-Personalization)
Trong ngành bán lẻ, việc dự đoán khách hàng muốn gì trong 5 giây tới là chìa khóa. Hệ thống sử dụng Snowpipe Streaming hoặc Spark Streaming để thu thập clickstream từ app, xử lý feature ngay lập tức trong Lakehouse và đẩy vào mô hình Inference để hiển thị sản phẩm gợi ý.
2. Bảo trì dự báo (Predictive Maintenance)
Trong sản xuất, dữ liệu từ hàng vạn cảm biến (IoT) đổ về dưới dạng logs dày đặc. Lakehouse lưu trữ khối lượng khổng lồ này, thực hiện phân tích thống kê để phát hiện xu hướng hỏng hóc và huấn luyện mô hình dự báo trước khi máy móc thực sự gặp sự cố.
3. Phát hiện gian lận tài chính (Fraud Detection)
Ngân hàng cần kết hợp giữa dữ liệu giao dịch tức thời và dữ liệu lịch sử của khách hàng trong nhiều năm. Data Lakehouse cho Machine Learning cho phép truy vấn chéo giữa hai loại dữ liệu này với tốc độ mili giây, giúp ngăn chặn gian lận ngay khi nó vừa khởi phát.
Trade-offs và thách thức: Cái nhìn khách quan
Không có kiến trúc nào là hoàn hảo 100%. Khi triển khai Data Lakehouse cho Machine Learning, doanh nghiệp cần đối mặt với:
- Độ phức tạp trong việc quản lý bảng mở: Các định dạng như Iceberg hay Delta cần được bảo trì (vacuum, optimize) thường xuyên để tránh tình trạng “file nhỏ” gây chậm hệ thống.
- Kỹ năng nhân sự: Đội ngũ cần am hiểu cả về SQL truyền thống lẫn các công nghệ xử lý dữ liệu lớn như Spark hay các công cụ điều phối (Orchestration) như Airflow.
- Chi phí compute ẩn: Việc chạy các tác vụ AI không kiểm soát trên Cloud có thể khiến hóa đơn tăng vọt. Cần thiết lập các chính sách giới hạn (quotas) và giám sát chi phí chặt chẽ.
Tương lai của AI Data Platform: Hướng tới AI-Native Lakehouse
Chúng ta đang chứng kiến sự dịch chuyển từ việc “Lakehouse hỗ trợ AI” sang “AI-Native Lakehouse”. Trong tương lai gần:
- Tự động tối ưu hóa (Auto-optimization): AI sẽ tự động phân tích các truy vấn để tổ chức lại cấu trúc dữ liệu trong Lakehouse sao cho hiệu suất cao nhất.
- Xử lý đa phương thức (Multimodal) thực thụ: Ranh giới giữa văn bản, hình ảnh và bảng sẽ hoàn toàn biến mất trong lớp lưu trữ.
- Interoperability (Khả năng tương thích): Việc chuyển đổi giữa các Cloud (AWS, Azure, Google Cloud) sẽ trở nên vô hình đối với người dùng cuối nhờ các chuẩn mở như Iceberg.
Kết luận
Kiến trúc Data Lakehouse cho Machine Learning không chỉ đơn thuần là một trào lưu công nghệ, mà là sự tiến hóa tất yếu để đáp ứng nhu cầu khổng lồ về dữ liệu của kỷ nguyên trí tuệ nhân tạo. Bằng cách phá bỏ rào cản giữa kho dữ liệu và hồ dữ liệu, Lakehouse tạo ra một môi trường lý tưởng để các mô hình AI không chỉ thông minh hơn mà còn minh bạch, an toàn và dễ quản trị hơn.
Dù hành trình xây dựng một Lakehouse hoàn chỉnh có thể gặp nhiều thách thức, nhưng đây là khoản đầu tư mang lại lợi ích bền vững cho bất kỳ doanh nghiệp nào coi AI là trọng tâm của chiến lược phát triển.
FAQ – Câu hỏi thường gặp
1. Data Lakehouse cho Machine Learning có thay thế hoàn toàn Data Warehouse không?
Trong nhiều trường hợp là CÓ. Lakehouse cung cấp đầy đủ các tính năng của Warehouse nhưng linh hoạt hơn. Tuy nhiên, với các doanh nghiệp chỉ thuần túy làm báo cáo tài chính đơn giản, một Warehouse truyền thống vẫn có thể đủ dùng.
2. Tôi nên chọn Delta Lake hay Apache Iceberg cho AI workload?
Cả hai đều rất tốt. Nếu bạn sử dụng hệ sinh thái của Databricks, Delta Lake là lựa chọn mặc định. Nếu bạn ưu tiên tính tương thích đa công cụ (Snowflake, Cloudera, AWS) và muốn sở hữu dữ liệu hoàn toàn mở, Apache Iceberg đang chiếm ưu thế.
3. Làm sao để kiểm soát chi phí khi chạy ML trên Lakehouse?
Hãy chú trọng vào việc tách biệt Workload (chia cụm compute cho BI và ML riêng), sử dụng tính năng tự động tắt (auto-suspend) và thường xuyên tối ưu hóa kích thước tệp tin trong Storage.
4. Lakehouse hỗ trợ RAG như thế nào?
Lakehouse đóng vai trò là “nguồn tri thức duy nhất”, nơi bạn lưu trữ cả văn bản thô và các vector tương ứng. Các dịch vụ như Vector Search sẽ truy vấn trực tiếp trên nền tảng này để cung cấp ngữ cảnh cho LLM.
Công ty TNHH Giải pháp Phân tích Dữ liệu Insight Data (INDA) là đơn vị hàng đầu cung cấp các dịch vụ và giải pháp về dữ liệu và trí tuệ nhân tạo (AI). Với chuyên môn sâu trong lĩnh vực Big Data, Data Analytics và AI Data Platform, chúng tôi cung cấp danh mục dịch vụ toàn diện bao gồm tư vấn và triển khai, thuê ngoài nhân sự IT, đào tạo và cung cấp bản quyền phần mềm.
Đội ngũ chuyên gia giàu kinh nghiệm của chúng tôi luôn cam kết đề cao chất lượng, tính chuyên nghiệp và sự thấu hiểu khách hàng – đồng hành cùng doanh nghiệp để mang đến những giải pháp phù hợp, hiệu quả, giúp khai mở tối đa tiềm năng từ dữ liệu.
Một số dịch vụ cơ bản INDA đang cung cấp:
Triển khai kho dữ liệu: Tư vấn, xây dựng, hỗ trợ về Data Warehouse và di chuyển Data Warehouse lên cloud.
Dịch vụ phát triển phần mềm: Tư vấn và hỗ trợ trang bị giấy phép phần mềm bản quyền (License).
Dịch vụ Outsourcing – Cho thuê nhân sự ngành Data: Tuyển dụng và sàng lọc ứng viên, có phương án dự phòng thay thế nhân sự kịp thời.
Dịch vụ Xây dựng Báo cáo BI: Cung cấp giải pháp chuyên sâu về Power BI.