

Một sai lầm phổ biến khi tối ưu Data Lakehouse là tập trung quá nhiều vào storage (S3, GCS) hoặc table format (Iceberg, Delta, Hudi), trong khi bỏ qua thành phần thực sự quyết định hiệu năng truy vấn: query engine. Trong thực tế, nhiều hệ thống có data layout tốt nhưng vẫn gặp tình trạng dashboard chậm, query tốn chi phí hoặc không scale được concurrency. Nguyên nhân thường nằm ở việc chọn sai engine hoặc dùng đúng engine nhưng sai workload.
Điểm quan trọng cần hiểu là: storage chỉ quyết định dữ liệu nằm ở đâu, table format quyết định dữ liệu được tổ chức ra sao, còn query engine mới là thành phần quyết định dữ liệu được đọc và xử lý như thế nào. Khi hệ thống bắt đầu scale, chính cách engine lập kế hoạch và thực thi query sẽ trở thành yếu tố chi phối chi phí và latency.
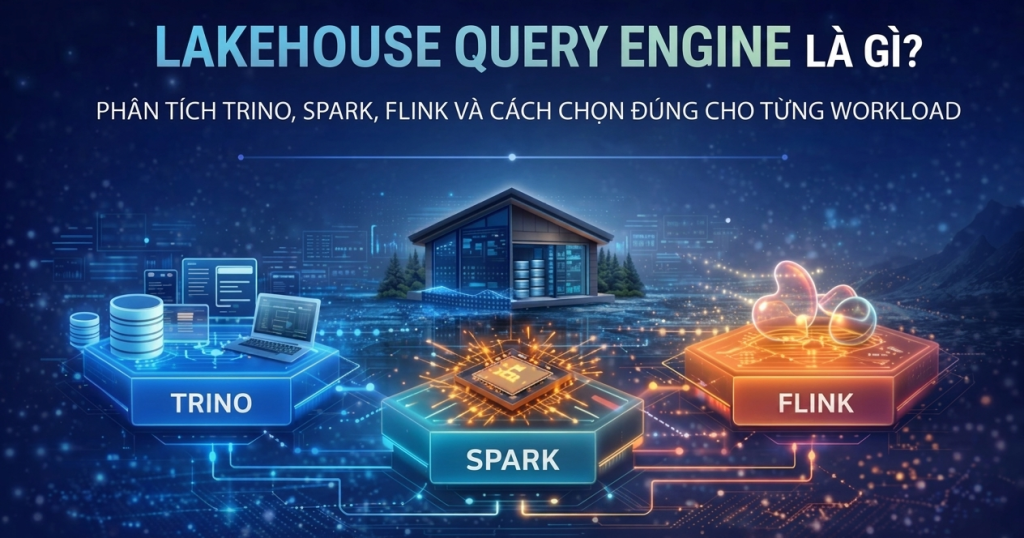
Table of Contents
Lakehouse Query Engine là gì và khác gì database engine?
Lakehouse query engine là một lớp compute chuyên trách việc parse, optimize và execute truy vấn trên dữ liệu lưu trữ ngoài (external storage). Không giống database truyền thống, engine không quản lý dữ liệu vật lý mà hoạt động như một lớp xử lý tách biệt, có thể scale độc lập.
Trong kiến trúc lakehouse hiện đại, query engine đóng vai trò trung gian giữa ba lớp:
- Storage layer: nơi dữ liệu được lưu (object storage)
- Table format: nơi định nghĩa metadata và snapshot
- Consumption layer: nơi người dùng truy vấn (BI, dashboard, API)
Sự tách biệt này tạo ra mô hình “separation of compute and storage”, cho phép tổ chức tối ưu chi phí bằng cách scale compute theo nhu cầu thay vì scale storage. Tuy nhiên, nó cũng đặt ra yêu cầu cao hơn về việc lựa chọn engine phù hợp, vì mỗi engine có cách tối ưu query hoàn toàn khác nhau.
Bên trong một query: vì sao cùng một SQL nhưng chạy nhanh/chậm khác nhau?
Để hiểu rõ sự khác biệt giữa các query engine, cần nhìn vào lifecycle của một truy vấn. Một câu SQL không được thực thi trực tiếp, mà trải qua nhiều bước biến đổi trước khi chạy trên cluster.
Đầu tiên, engine sẽ parse câu SQL thành một biểu diễn logic. Sau đó, query planner xây dựng logical plan — một dạng mô tả cách dữ liệu cần được xử lý. Tại đây, optimizer (thường là cost-based optimizer) sẽ đánh giá nhiều phương án thực thi khác nhau, dựa trên thống kê dữ liệu và cost model, để chọn ra physical plan tối ưu nhất. Cuối cùng, execution engine sẽ chia nhỏ plan này thành các task và phân phối lên cluster để chạy song song.
Điểm mấu chốt nằm ở optimizer. Trong thực tế, hai engine khác nhau có thể tạo ra hai execution plan hoàn toàn khác nhau cho cùng một query. Một engine có thể push filter xuống storage (predicate pushdown), chỉ đọc 10% dữ liệu, trong khi engine khác lại scan toàn bộ dataset. Sự khác biệt này trực tiếp ảnh hưởng đến cả latency lẫn chi phí compute.
Sự khác biệt cốt lõi giữa các Lakehouse Query Engine
Các query engine phổ biến như Trino, Spark SQL hay Flink không phải là các công cụ tương đương, mà được thiết kế cho các mục tiêu khác nhau ngay từ đầu. Sự khác biệt này thể hiện rõ nhất ở cách chúng cân bằng giữa latency, throughput và khả năng xử lý dữ liệu theo thời gian.
| Engine | Triết lý thiết kế | Điểm mạnh | Trade-off |
| Trino | Interactive query | Latency thấp | Không tối ưu ETL |
| Spark SQL | Batch compute | Throughput cao | Query chậm hơn |
| Flink SQL | Streaming-first | Real-time | Complexity cao |
Điều này dẫn đến một insight quan trọng trong thực tế: không có query engine nào “tốt nhất”, mà chỉ có engine phù hợp với loại workload cụ thể.
Performance thực tế: latency, throughput và chi phí
Trong môi trường production, performance không chỉ là tốc độ trả kết quả, mà là tổng chi phí để đạt được kết quả đó. Đây là lý do cần phân biệt rõ giữa latency và throughput.
Trino được thiết kế cho interactive analytics, nơi người dùng cần query trả kết quả nhanh. Engine này sử dụng kiến trúc MPP (massively parallel processing), cho phép thực thi query với độ trễ thấp, đặc biệt hiệu quả cho dashboard hoặc ad-hoc query. Tuy nhiên, khi workload chuyển sang ETL hoặc xử lý dữ liệu lớn, Trino bắt đầu gặp hạn chế vì không tối ưu cho việc xử lý pipeline phức tạp.
Ngược lại, Spark SQL được xây dựng trên một distributed compute engine mạnh mẽ, tối ưu cho throughput. Trong các pipeline ETL, Spark có thể xử lý khối lượng dữ liệu lớn với hiệu quả cao, nhưng cái giá phải trả là latency. Một query đơn lẻ trên Spark thường chậm hơn so với Trino do overhead trong việc khởi tạo job và scheduling.
Flink lại đi theo hướng khác, tập trung vào streaming. Thay vì xử lý dữ liệu theo batch, Flink xử lý dữ liệu liên tục, giúp giảm latency xuống mức gần real-time. Tuy nhiên, điều này đi kèm với độ phức tạp cao hơn trong việc vận hành và thiết kế pipeline.
Một insight quan trọng từ thực tế là: chi phí compute thường tăng nhanh khi engine phải xử lý workload không đúng với thiết kế của nó. Ví dụ, dùng Spark cho dashboard có thể khiến mỗi query phải khởi tạo job mới, làm tăng latency và chi phí. Ngược lại, dùng Trino cho ETL có thể dẫn đến việc chạy nhiều query nhỏ thay vì một pipeline tối ưu, làm tăng tổng chi phí.
Real-world scenario: chọn engine trong các hệ thống thực tế
Trong các hệ thống production, việc lựa chọn query engine thường không dựa trên lý thuyết, mà dựa trên workload cụ thể.
Trong một hệ thống BI cho e-commerce, nơi hàng trăm dashboard cần query dữ liệu gần như realtime, Trino thường là lựa chọn hợp lý. Khả năng trả kết quả nhanh và hỗ trợ nhiều data source giúp đáp ứng nhu cầu của analyst mà không cần xây dựng pipeline phức tạp.
Ngược lại, trong một hệ thống ETL xử lý dữ liệu từ nhiều nguồn (log, transaction, event), Spark lại phù hợp hơn. Khả năng xử lý batch lớn và tích hợp tốt với các công cụ data engineering giúp giảm độ phức tạp của pipeline.
Trong các hệ thống real-time như fraud detection hoặc tracking user behavior, Flink thường được sử dụng vì khả năng xử lý event ngay khi chúng đến. Tuy nhiên, việc vận hành Flink đòi hỏi team có kinh nghiệm, vì việc debug và monitor streaming pipeline phức tạp hơn nhiều so với batch.
Một pattern phổ biến trong các hệ thống lớn là multi-engine architecture, trong đó mỗi engine được dùng cho một loại workload riêng. Ví dụ, dữ liệu có thể được ingest bằng Flink, xử lý batch bằng Spark, và phục vụ query bằng Trino. Cách tiếp cận này giúp tận dụng điểm mạnh của từng engine thay vì cố gắng tìm một giải pháp duy nhất.
Integration với Table Format: yếu tố thường bị đánh giá thấp
Query engine không hoạt động độc lập mà phụ thuộc chặt chẽ vào table format. Một số combination phổ biến như Iceberg với Trino hoặc Delta Lake với Spark không phải là ngẫu nhiên, mà phản ánh sự tương thích giữa cách engine đọc dữ liệu và cách metadata được tổ chức.
Iceberg, với khả năng metadata pruning mạnh, thường kết hợp tốt với Trino trong các workload analytics. Delta Lake, được tối ưu cho Spark, tận dụng tốt các optimization như caching và data skipping. Nếu chọn sai combination, hiệu năng có thể giảm đáng kể ngay cả khi từng thành phần riêng lẻ đều mạnh.
Những sai lầm phổ biến khi chọn Query Engine
Trong thực tế, nhiều hệ thống gặp vấn đề không phải vì công nghệ yếu, mà vì lựa chọn sai.
Các sai lầm thường gặp:
- Dùng Spark cho BI → dashboard chậm do latency cao
- Dùng Trino cho ETL → pipeline kém hiệu quả
- Không tối ưu data layout → engine không thể tối ưu query
- Bỏ qua cost model → chi phí tăng khi scale
Một điểm đáng chú ý là nhiều team chỉ nhận ra những vấn đề này khi hệ thống đã đi vào production và chi phí bắt đầu tăng mạnh.
Tối ưu hiệu năng: engine chỉ là một phần của bài toán
Hiệu năng của query engine phụ thuộc rất lớn vào cách dữ liệu được tổ chức. Trong nhiều trường hợp, tối ưu data layout mang lại hiệu quả lớn hơn việc đổi engine.
Các yếu tố quan trọng bao gồm:
- Partitioning hợp lý để giảm data scan
- File size đủ lớn để tránh small files problem
- Sử dụng predicate pushdown và column pruning
Trong các hệ thống lớn, việc tối ưu metadata (đặc biệt với Iceberg) có thể giảm đáng kể chi phí query mà không cần thay đổi engine.
Xu hướng tương lai: multi-engine và serverless
Data Lakehouse đang chuyển dần sang mô hình multi-engine, nơi nhiều query engine cùng tồn tại và phục vụ các workload khác nhau. Đồng thời, serverless query engine cũng đang trở nên phổ biến, giúp giảm overhead vận hành và cho phép scale compute linh hoạt hơn.
Điều này làm cho việc hiểu rõ từng engine trở nên quan trọng hơn, vì hệ thống không còn phụ thuộc vào một công cụ duy nhất.
Kết luận
Lakehouse Query Engine là thành phần quyết định hiệu năng thực tế của Data Lakehouse. Storage và table format chỉ tạo nền tảng, còn query engine mới là nơi dữ liệu được xử lý và biến thành insight. Sự khác biệt giữa Trino, Spark và Flink không nằm ở việc engine nào mạnh hơn, mà nằm ở việc chúng được thiết kế cho loại workload nào.
Trong thực tế, hệ thống hiệu quả nhất không phải là hệ thống chọn đúng một engine, mà là hệ thống hiểu rõ trade-off và biết kết hợp nhiều engine để tận dụng điểm mạnh của từng loại. Đây cũng chính là sự khác biệt giữa một kiến trúc có thể scale và một hệ thống chỉ hoạt động tốt ở quy mô nhỏ.
Công ty TNHH Giải pháp Phân tích Dữ liệu Insight Data (INDA) là đơn vị hàng đầu cung cấp các dịch vụ và giải pháp về dữ liệu và trí tuệ nhân tạo (AI). Với chuyên môn sâu trong lĩnh vực Big Data, Data Analytics và AI Data Platform, chúng tôi cung cấp danh mục dịch vụ toàn diện bao gồm tư vấn và triển khai, thuê ngoài nhân sự IT, đào tạo và cung cấp bản quyền phần mềm.
Đội ngũ chuyên gia giàu kinh nghiệm của chúng tôi luôn cam kết đề cao chất lượng, tính chuyên nghiệp và sự thấu hiểu khách hàng – đồng hành cùng doanh nghiệp để mang đến những giải pháp phù hợp, hiệu quả, giúp khai mở tối đa tiềm năng từ dữ liệu.
Một số dịch vụ cơ bản INDA đang cung cấp:
Triển khai kho dữ liệu: Tư vấn, xây dựng, hỗ trợ về Data Warehouse và di chuyển Data Warehouse lên cloud.
Dịch vụ phát triển phần mềm: Tư vấn và hỗ trợ trang bị giấy phép phần mềm bản quyền (License).
Dịch vụ Outsourcing – Cho thuê nhân sự ngành Data: Tuyển dụng và sàng lọc ứng viên, có phương án dự phòng thay thế nhân sự kịp thời.
Dịch vụ Xây dựng Báo cáo BI: Cung cấp giải pháp chuyên sâu về Power BI.


