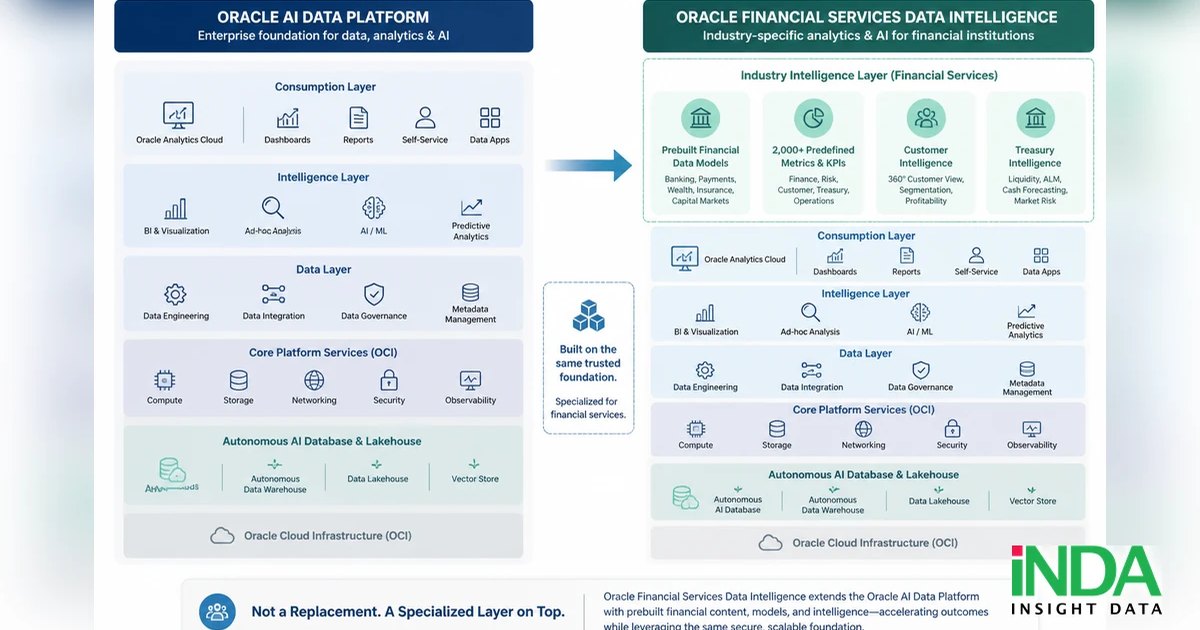
Oracle AI Data Platform (AI DP) đang định nghĩa lại cách các doanh nghiệp tiếp cận với trí tuệ nhân tạo bằng cách không chỉ cung cấp các mô hình ngôn ngữ lớn (LLM) mà còn xây dựng một nền tảng dữ liệu toàn diện. Trái tim của hệ sinh thái này chính là Oracle Autonomous AI Lakehouse, lớp dữ liệu nền tảng đóng vai trò then chốt trong việc phá bỏ rào cản giữa các silo dữ liệu. Đối với các kiến trúc sư dữ liệu và CTO, việc hiểu rõ vai trò của thành phần này là điều bắt buộc để hiện thực hóa chiến lược AI-First, chuyển đổi từ việc sở hữu dữ liệu sang việc khai thác giá trị thực từ dữ liệu đó.
Table of Contents
Oracle Autonomous AI Lakehouse là gì và vai trò trong AI DP
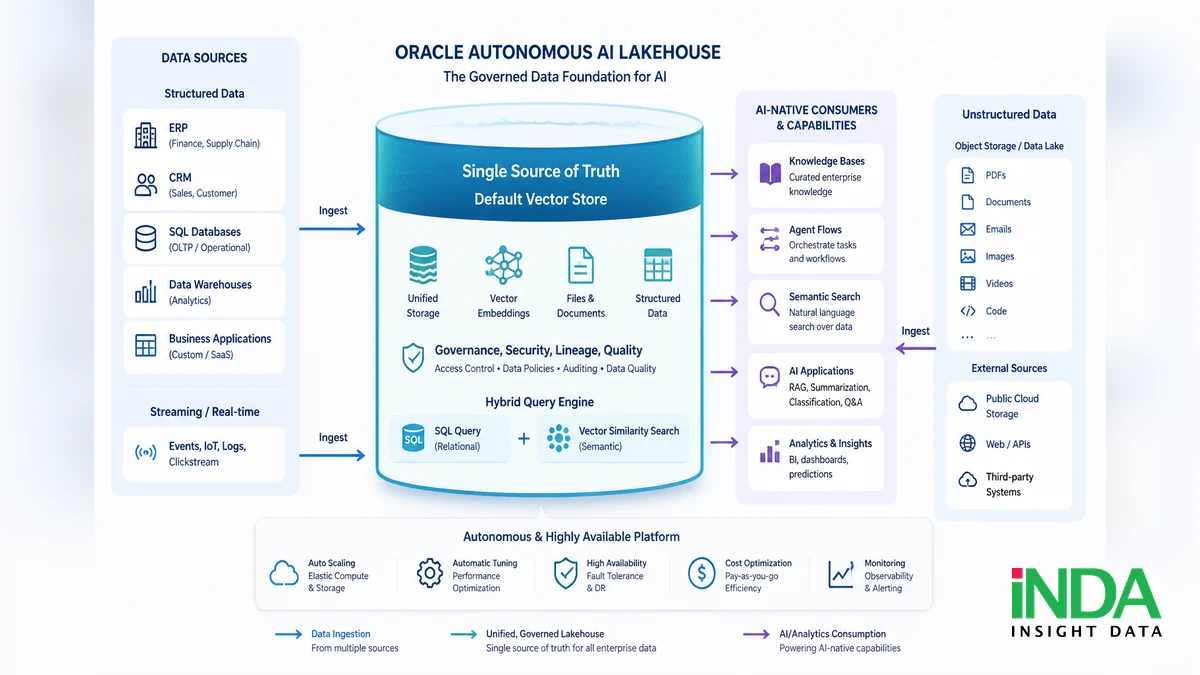
Oracle Autonomous AI Lakehouse là lớp dữ liệu nền tảng (foundational data layer) trong hệ sinh thái Oracle AI Data Platform, được thiết kế để lưu trữ, quản lý và cung cấp dữ liệu cho các ứng dụng trí tuệ nhân tạo. Khác với các kiến trúc truyền thống tách rời giữa Data Warehouse và Data Lake, giải pháp này hợp nhất cả hai thế giới vào một môi trường tự quản (autonomous), cho phép truy cập dữ liệu đa dạng mà không cần di chuyển hay sao chép phức tạp.
Trong kiến trúc Oracle AI Data Platform, Oracle Autonomous AI Lakehouse đóng vai trò là một “single source of truth” (nguồn sự thật duy nhất) có khả năng xử lý cả dữ liệu có cấu trúc (structured data) từ các ứng dụng ERP, CRM và dữ liệu phi cấu trúc (unstructured data) như văn bản, hình ảnh, tài liệu PDF. Vai trò quan trọng nhất của nó là trở thành vector store mặc định, nơi lưu trữ các bản đại diện số học (embeddings) của dữ liệu doanh nghiệp. Đây là điều kiện tiên quyết để kích hoạt các năng lực AI-native như Knowledge Bases và Agent Flows. Nếu không có lớp Lakehouse này, nền tảng AI DP vẫn có thể thực hiện các tác vụ tích hợp và biến đổi dữ liệu cơ bản, nhưng toàn bộ sức mạnh của generative AI và các tác vụ suy luận thông minh sẽ bị vô hiệu hóa.
Sự khác biệt so với Data Lakehouse truyền thống
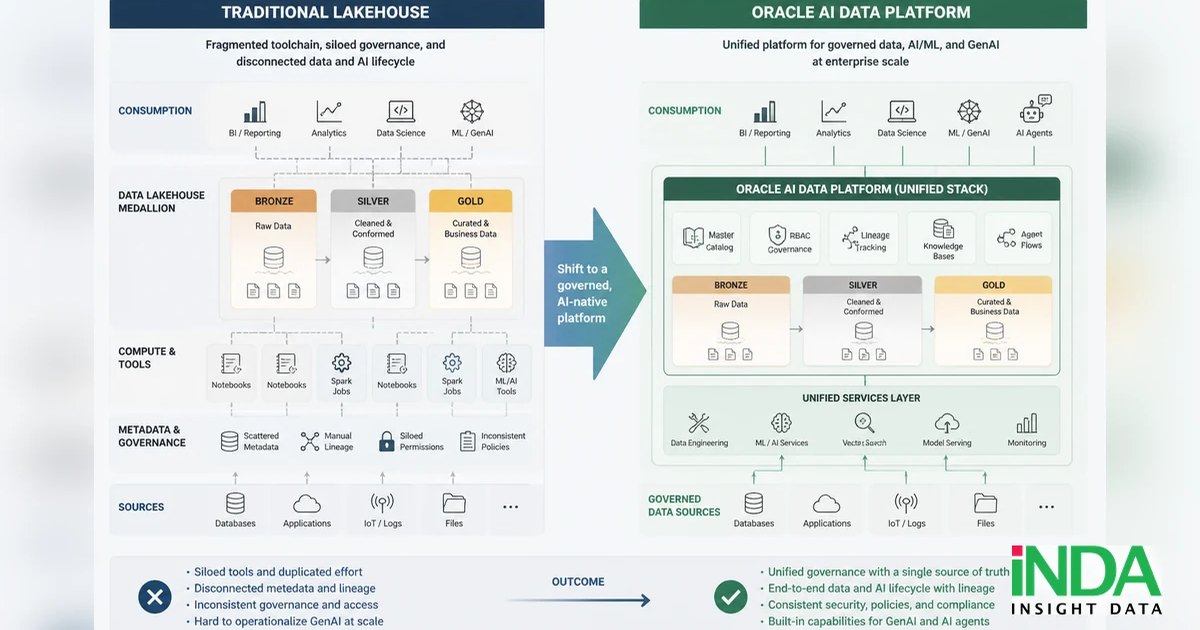
Một Data Lakehouse thông thường tập trung vào việc tối ưu hóa hiệu suất truy vấn và lưu trữ giá rẻ. Tuy nhiên, Oracle Autonomous AI Lakehouse tiến xa hơn bằng cách tích hợp trực tiếp các khả năng Vector Search ngay trong engine của nó. Điều này có nghĩa là thay vì phải sử dụng một cơ sở dữ liệu vector riêng biệt (như Pinecone hay Milvus) và thiết lập quy trình ETL phức tạp để đồng bộ dữ liệu, doanh nghiệp có thể thực hiện các truy vấn ngữ nghĩa (semantic search) ngay trên dữ liệu hiện hữu.
Thêm vào đó, tính chất “autonomous” giúp tự động hóa việc cấu hình, bảo mật và mở rộng quy mô. Đối với các trưởng nhóm dữ liệu, điều này giúp giảm bớt gánh nặng vận hành hạ tầng, cho phép đội ngũ tập trung vào việc tinh chỉnh các mô hình AI và xây dựng Knowledge Bases chất lượng cao. Khả năng tự vận hành này đảm bảo rằng lớp dữ liệu luôn sẵn sàng phục vụ các yêu cầu có độ trễ thấp từ các AI Agent.
Cấu trúc kỹ thuật dựa trên Autonomous Database và Object Storage
Kiến trúc của Oracle Autonomous AI Lakehouse được xây dựng dựa trên sự kết hợp chặt chẽ giữa Oracle Autonomous Database và OCI Object Storage. Oracle Autonomous Database đóng vai trò là bộ não điều khiển, cung cấp khả năng xử lý SQL mạnh mẽ và quản lý Metadata. Trong khi đó, OCI Object Storage cung cấp không gian lưu trữ vô hạn cho các tệp dữ liệu phi cấu trúc với chi phí tối ưu.
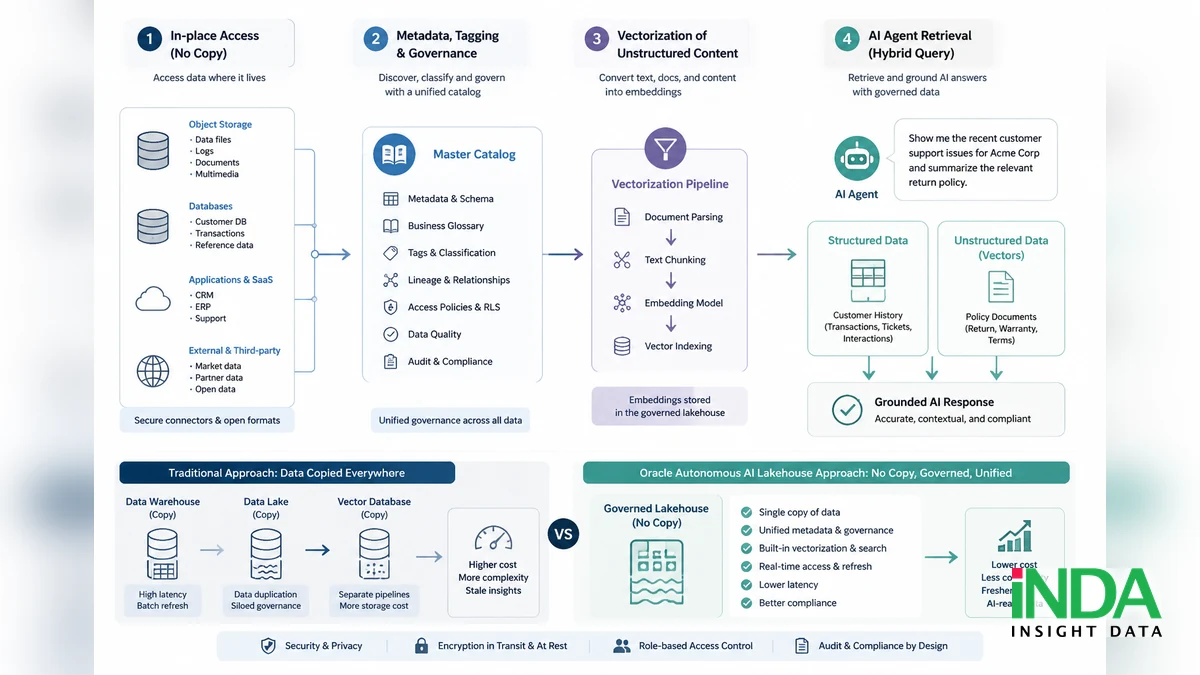
Sự kết hợp này cho phép thực hiện cơ chế “in-place access” (truy cập tại chỗ). Dữ liệu không cần phải nạp hoàn toàn vào cơ sở dữ liệu để có thể phân tích. Thay vào đó, Lakehouse có thể truy vấn trực tiếp các tệp Parquet, Avro hoặc JSON nằm trên Object Storage với hiệu suất tương đương dữ liệu nội bộ. Đây là một lợi thế cực lớn cho các dự án AI quy mô lớn, nơi khối lượng dữ liệu phi cấu trúc có thể lên tới hàng Petabyte.
Cách Oracle Autonomous AI Lakehouse hợp nhất dữ liệu đa nguồn
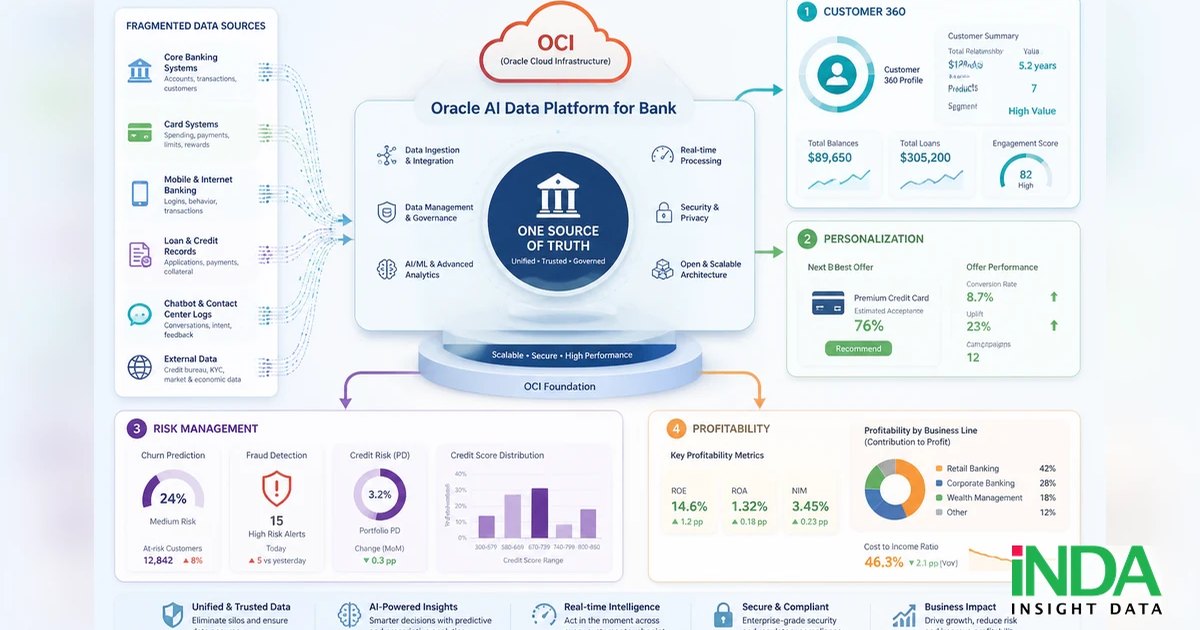
Thách thức lớn nhất của các tổ chức hiện nay là sự phân mảnh dữ liệu. Dữ liệu có cấu trúc thường nằm trong các hệ thống quan hệ chặt chẽ, trong khi dữ liệu tiềm năng cho AI lại nằm rải rác dưới dạng tài liệu văn phòng, email, và bản ghi cuộc gọi. Oracle Autonomous AI Lakehouse giải quyết vấn đề này bằng cách cung cấp một giao diện quản lý thống nhất, cho phép hợp nhất structured data và unstructured data mà không làm thay đổi cấu trúc gốc của chúng.
Thông qua các dịch vụ tích hợp của Oracle AI Data Platform, dữ liệu từ các nguồn bên ngoài (như AWS S3, Azure Blob Storage hoặc các Database on-premises) có thể được kết nối trực tiếp vào Lakehouse. Quá trình này không đòi hỏi phải copy dữ liệu về một nơi duy nhất, giúp giảm rủi ro về an ninh mạng và tiết kiệm chi phí băng thông. Việc hợp nhất này tạo ra một Governed Data Foundation – một nền tảng dữ liệu có quản trị, nơi mọi thành phần dữ liệu đều có danh tính và quyền truy cập rõ ràng.
Quản trị thông qua Master Catalog và Metadata Layer
Để dữ liệu hợp nhất thực sự có giá trị cho AI, nó cần được gán nhãn và hiểu rõ ngữ cảnh. Oracle Autonomous AI Lakehouse sử dụng Master Catalog để quản lý lớp Metadata thống nhất. Đây là nơi lưu trữ thông tin về cấu trúc dữ liệu, nguồn gốc (Lineage) và các quy tắc quản trị. Master Catalog cho phép các AI Agent hiểu được rằng một cột dữ liệu trong bảng SQL và một đoạn văn bản trong file PDF đều đang mô tả cùng một khách hàng.
Khả năng Lineage (truy xuất nguồn gốc) trong Master Catalog đặc biệt quan trọng đối với các ngành yêu cầu tuân thủ khắt khe như tài chính hay y tế. Khi một AI Model đưa ra một câu trả lời, doanh nghiệp có thể truy ngược lại xem dữ liệu nào trong Oracle Autonomous AI Lakehouse đã được sử dụng để tạo ra câu trả lời đó. Điều này xây dựng niềm tin vào hệ thống AI và giúp dễ dàng kiểm toán khi cần thiết.
Chiến lược no-copy và in-place access
Một trong những sai lầm phổ biến của các kiến trúc dữ liệu cũ là tạo ra quá nhiều bản sao (replica) để phục vụ các mục đích khác nhau: một bản cho báo cáo BI, một bản cho Data Science, và một bản cho AI. Oracle Autonomous AI Lakehouse triệt tiêu sự lãng phí này bằng kiến trúc no-copy.
Bằng cách sử dụng các liên kết ảo và engine truy vấn phân tán, người dùng có thể thực hiện các phân tích phức tạp ngay trên dữ liệu nguồn. Điều này không chỉ giúp tiết kiệm không gian lưu trữ mà còn đảm bảo tính thời gian thực (Real-Time) của dữ liệu. Khi dữ liệu trong Object Storage được cập nhật, các vector embeddings trong Lakehouse cũng có thể được làm mới gần như ngay lập tức, đảm bảo Knowledge Bases của AI luôn mang thông tin mới nhất.
Vai trò là vector store mặc định cho các năng lực AI-native
Trong kiến trúc Oracle AI Data Platform, các thành phần như Knowledge Bases (KB), Agent Flows và AI Compute không thể hoạt động độc lập mà không có sự hỗ trợ của Oracle Autonomous AI Lakehouse. Thành phần này đóng vai trò là default vector store, lưu trữ các vector có chiều không gian lớn đại diện cho ý nghĩa ngữ nghĩa của dữ liệu.
Khi một doanh nghiệp xây dựng một Knowledge Base để hỗ trợ dịch vụ khách hàng, Oracle Autonomous AI Lakehouse sẽ thực hiện quá trình “vectorization” (vector hóa) các tài liệu hướng dẫn sử dụng, chính sách bảo hành. Khi khách hàng đặt câu hỏi, AI DP sẽ sử dụng các vector này để tìm kiếm các đoạn văn bản có liên quan nhất một cách cực kỳ nhanh chóng. Việc tích hợp vector store vào ngay lớp Lakehouse giúp loại bỏ độ trễ truyền tải dữ liệu giữa các hệ thống rời rạc, một yếu tố sống còn đối với trải nghiệm người dùng trong generative AI.
Kích hoạt Knowledge Bases và Agent Flows
Agent Flows là một chuỗi các tác vụ tự động mà AI thực hiện để hoàn thành một mục tiêu cụ thể. Để làm được điều này, Agent cần truy cập vào kiến thức doanh nghiệp được lưu trữ trong Knowledge Bases. Oracle Autonomous AI Lakehouse chính là kho lưu trữ trung tâm cung cấp nhiên liệu cho các luồng công việc này.
Nếu một Agent cần kiểm tra lịch sử mua hàng (dữ liệu có cấu trúc) và đối chiếu với chính sách đổi trả (dữ liệu phi cấu trúc), nó có thể thực hiện một truy vấn duy nhất tới Lakehouse. Khả năng truy vấn lai (hybrid query) này là một lợi thế độc đáo của Oracle, cho phép kết hợp sức mạnh của SQL truyền thống với tìm kiếm vector hiện đại. Sự phối hợp này giúp các ứng dụng AI không chỉ biết nói năng lưu loát mà còn cực kỳ chính xác về mặt dữ liệu nghiệp vụ.
Tác động khi không có Autonomous AI Lakehouse
Cần lưu ý rằng Oracle AI Data Platform vẫn cho phép thực hiện các thao tác ingest và transform dữ liệu mà không cần bật tính năng AI-native. Tuy nhiên, trong trường hợp này, nền tảng chỉ hoạt động như một công cụ ETL/ELT thông thường. Các doanh nghiệp sẽ không thể sử dụng AI Compute để huấn luyện lại mô hình hoặc sử dụng các Agent để tự động hóa quy trình dựa trên dữ liệu doanh nghiệp.
Điều này nhấn mạnh rằng Oracle Autonomous AI Lakehouse không chỉ là một lựa chọn lưu trữ thêm vào, mà là “xương sống” để chuyển đổi một nền tảng dữ liệu tĩnh thành một hệ sinh thái AI động. Đối với các dự án POC (Proof of Concept) về AI, việc thiết lập Lakehouse ngay từ đầu là bước đi chiến lược để đảm bảo khả năng mở rộng trong tương lai.
Xây dựng Governed Data Foundation cho trí tuệ nhân tạo
Dữ liệu dùng cho AI nếu không được quản trị tốt sẽ dẫn đến những kết quả sai lệch hoặc vi phạm quyền riêng tư. Oracle Autonomous AI Lakehouse thiết lập một Governed Data Foundation bằng cách áp dụng các chính sách bảo mật đồng nhất trên toàn bộ Lakehouse. Dù dữ liệu đang nằm ở dạng bảng trong Database hay dạng file trong Object Storage, các quy tắc về quyền truy cập (Access Control) vẫn được thực thi nghiêm ngặt.
Nền tảng này tích hợp với các dịch vụ bảo mật của OCI để đảm bảo mã hóa dữ liệu cả khi lưu trữ và khi đang truyền tải. Quan trọng hơn, với vai trò là một phần của Oracle AI Data Platform, nó hỗ trợ việc ẩn danh dữ liệu (data masking) và lọc các thông tin định danh cá nhân (PII) trước khi đưa vào các mô hình AI. Điều này giúp các doanh nghiệp trong các lĩnh vực nhạy cảm có thể yên tâm tận dụng sức mạnh của đám mây mà vẫn tuân thủ các quy định pháp lý.
Tích hợp với Oracle Fusion Data Intelligence
Một điểm mạnh khác của Oracle Autonomous AI Lakehouse là khả năng tích hợp sâu với Oracle Fusion Data Intelligence. Đối với các doanh nghiệp đang sử dụng các ứng dụng Oracle Fusion (như ERP, HCM, SCM), dữ liệu từ các ứng dụng này có thể được tự động chảy vào Lakehouse để sẵn sàng cho các phân tích AI.
Sự tích hợp này giúp rút ngắn thời gian từ lúc có dữ liệu thô đến khi có được thông tin dự báo từ AI. Thay vì mất hàng tháng để xây dựng đường ống dữ liệu, doanh nghiệp có thể sử dụng các schema đã được định nghĩa sẵn và các mô hình dữ liệu tối ưu hóa cho AI. Đây là cách Oracle giúp các khách hàng lớn nhanh chóng đạt được ROI (tỷ lệ lợi nhuận trên đầu tư) cao khi triển khai Oracle AI Data Platform cho doanh nghiệp đa nguồn dữ liệu.
Tối ưu hóa cho AI Compute và Workloads hiệu suất cao
Các tác vụ AI thường đòi hỏi tài nguyên tính toán cực lớn và tốc độ đọc ghi dữ liệu nhanh. Oracle Autonomous AI Lakehouse tận dụng hạ tầng Exadata bên dưới để cung cấp hiệu suất vượt trội cho các AI workloads. Khả năng tự động điều chỉnh (auto-tuning) giúp hệ thống nhận diện các mẫu truy cập dữ liệu của AI và tối ưu hóa các chỉ mục (indexes) hoặc cache tương ứng.
Khi chạy các tác vụ AI Compute lớn, Lakehouse có thể tự động mở rộng tài nguyên để xử lý các yêu cầu đồng thời mà không làm ảnh hưởng đến các báo cáo BI truyền thống đang chạy song song. Sự cô lập tài nguyên này đảm bảo tính ổn định cho toàn bộ hệ thống CNTT của doanh nghiệp.
Câu hỏi thường gặp về Oracle Autonomous AI Lakehouse
Oracle Autonomous AI Lakehouse khác gì so với Data Warehouse truyền thống?
Data Warehouse truyền thống chủ yếu xử lý dữ liệu có cấu trúc để làm báo cáo quá khứ. Trong khi đó, Oracle Autonomous AI Lakehouse được thiết kế cho cả dữ liệu có cấu trúc và phi cấu trúc, đồng thời tích hợp sẵn vector store để phục vụ các ứng dụng AI tương lai và phân tích thời gian thực.
Tôi có cần phải di chuyển toàn bộ dữ liệu về OCI để dùng Lakehouse không?
Không nhất thiết. Nhờ kiến trúc in-place access và khả năng kết nối đa đám mây, Oracle Autonomous AI Lakehouse có thể truy vấn dữ liệu tại chỗ từ AWS, Azure hoặc các hệ thống on-premises. Tuy nhiên, việc lưu trữ dữ liệu quan trọng trên OCI sẽ mang lại hiệu suất tốt nhất và độ trễ thấp nhất cho các ứng dụng AI.
Tại sao Autonomous AI Lakehouse lại là thành phần bắt buộc cho AI-native features?
Các tính năng AI-native như Knowledge Bases yêu cầu khả năng tìm kiếm vector và quản lý Metadata phức tạp để hiểu được ngữ nghĩa của dữ liệu doanh nghiệp. Oracle Autonomous AI Lakehouse cung cấp hạ tầng cần thiết để lưu trữ và truy vấn các vector này, điều mà các lớp lưu trữ thông thường không thể làm được một cách hiệu quả.
Master Catalog trong nền tảng này giúp gì cho các kiến trúc sư dữ liệu?
Master Catalog giúp các kiến trúc sư có cái nhìn toàn cảnh về tài sản dữ liệu của doanh nghiệp. Nó tự động thu thập Metadata, thiết lập sơ đồ quan hệ và theo dõi nguồn gốc dữ liệu. Điều này giúp việc quản trị dữ liệu trở nên dễ dàng hơn, đặc biệt khi phải đối mặt với các yêu cầu về tuân thủ và đạo đức AI.
INDA đồng hành cùng doanh nghiệp triển khai Oracle Autonomous AI Lakehouse
Việc triển khai một kiến trúc Lakehouse hiện đại đòi hỏi sự am hiểu sâu sắc về cả hạ tầng dữ liệu lẫn các mô hình AI mới nhất. INDA tự hào là đơn vị tư vấn và triển khai hàng đầu, giúp các doanh nghiệp Việt Nam tiếp cận và làm chủ sức mạnh của Oracle AI Data Platform. Chúng tôi hỗ trợ khách hàng từ giai đoạn đánh giá hiện trạng, thiết kế kiến trúc Governed Data Foundation cho đến việc hiện thực hóa các Knowledge Bases và Agent Flows.
Với đội ngũ chuyên gia giàu kinh nghiệm trong lĩnh vực Data Lakehouse và AI, INDA cam kết mang lại giải pháp tối ưu, giúp doanh nghiệp hợp nhất dữ liệu một cách an toàn và hiệu quả. Chúng tôi không chỉ cung cấp giải pháp kỹ thuật mà còn đồng hành cùng khách hàng trong việc xây dựng quy trình quản trị dữ liệu chuẩn quốc tế, đảm bảo rằng Oracle Autonomous AI Lakehouse thực sự trở thành bệ phóng cho sự đổi mới sáng tạo.
Hãy liên hệ với INDA ngay hôm nay để nhận tư vấn chuyên sâu về cách xây dựng nền tảng Oracle Autonomous AI Lakehouse vững chắc cho lộ trình chuyển đổi số của bạn.
Đọc thêm về dữ liệu và chuyển đổi số
- Oracle PAF là gì? Doanh nghiệp dùng nền tảng no-code này ra sao
- Oracle Analytics Cloud cho doanh nghiệp